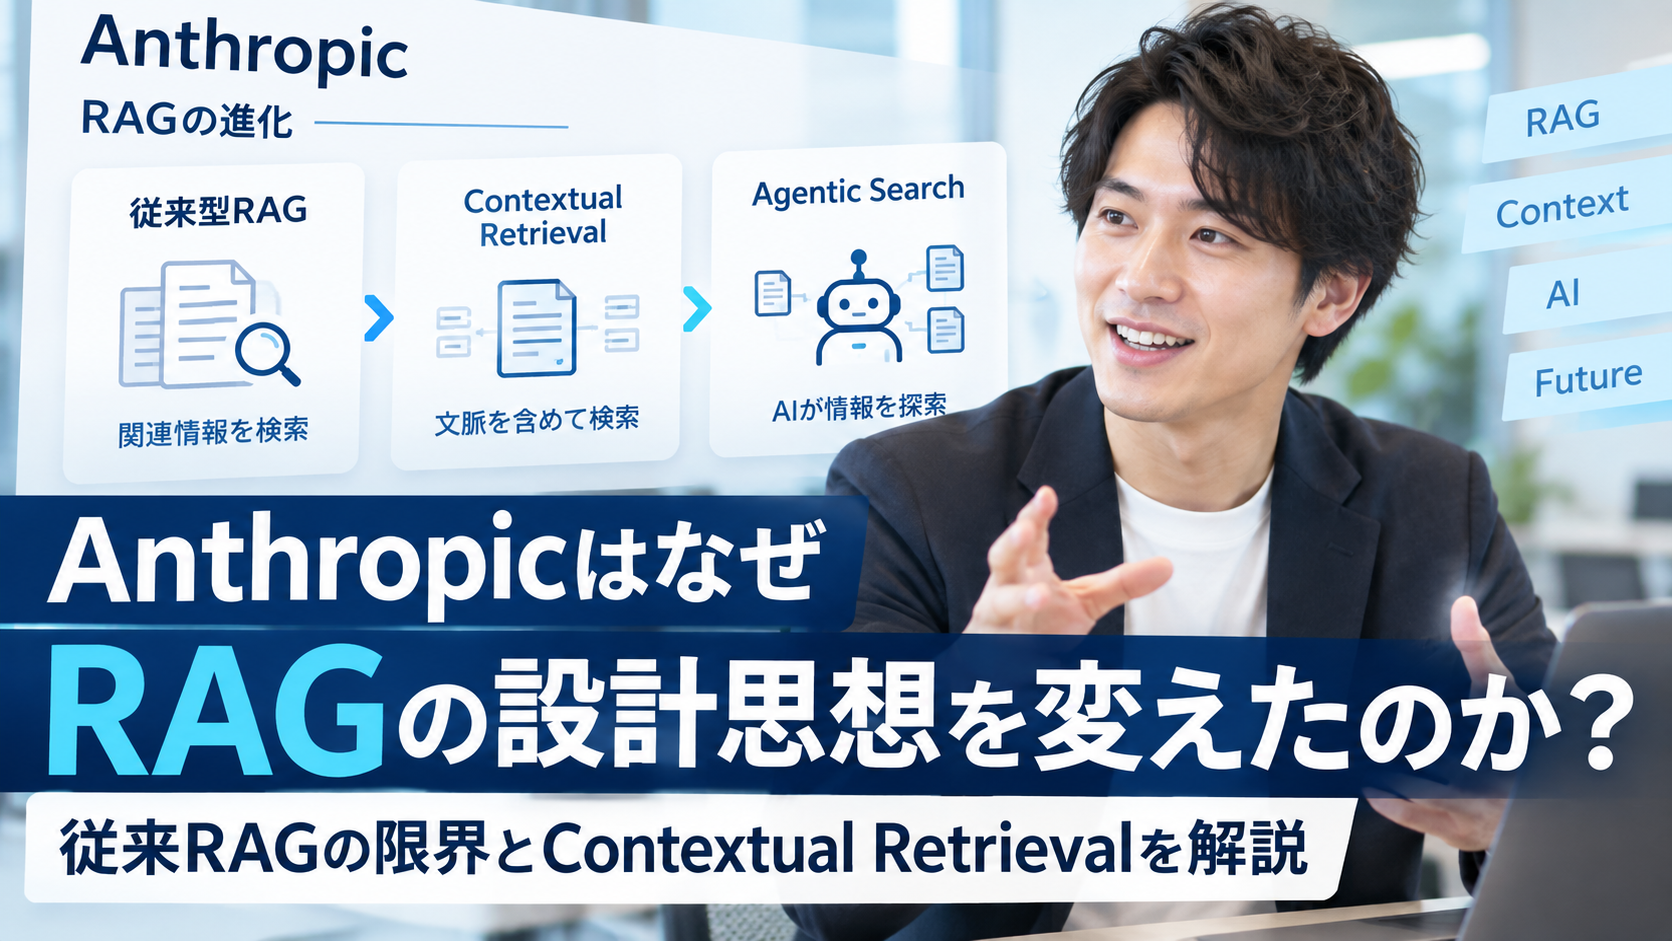
Anthropicは、RAGを単なる「検索して情報をLLMに渡す仕組み」ではなく、「AIが必要な情報を、必要なタイミングで取得する仕組み」として捉える方向へ設計思想を広げています。
従来のRAGでは、文書を細かく分割して検索することで、前後の文脈が失われたり、本当に必要な情報を取得できなかったりする課題がありました。
そこでAnthropicは、チャンクに文脈を補うContextual Retrievalを提案し、さらにAI自身が必要な情報を探すエージェント型の検索へと考え方を発展させています。
本記事では、AnthropicがなぜRAGの設計思想を変えたのかを整理し、従来RAGの限界からContextual Retrieval、AIエージェント、Context Engineeringまで分かりやすく解説します。
そもそもRAGとは何か
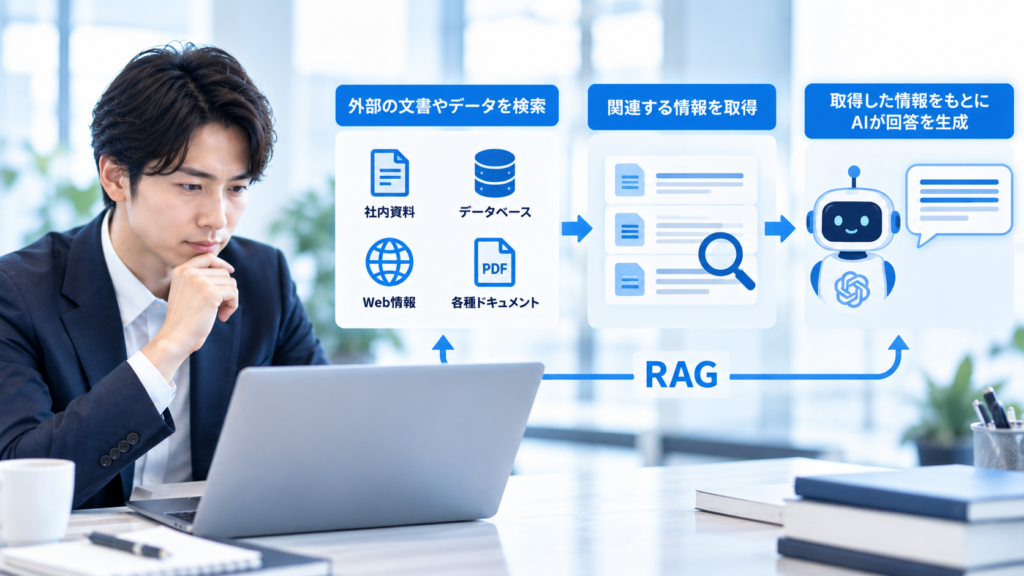
RAGとは、AIが回答する前に外部の文書やデータを検索し、取得した情報をもとに回答を生成する仕組みです。
LLMだけでは把握できない社内情報や独自データを扱えるため、社内検索や問い合わせ対応などで活用されています。
従来型RAGの基本的な仕組み
一般的なRAGは、文書を小さな単位に分割して保存し、質問に関連する情報を検索してLLMへ渡します。
| 手順 |
内容 |
| ① 文書を登録 |
マニュアルや社内資料などを用意する |
| ② 文書を分割 |
検索しやすい単位に分ける |
| ③ 情報を保存 |
検索できる状態にする |
| ④ 質問を検索 |
関連性の高い情報を探す |
| ⑤ LLMへ渡す |
質問と検索結果を渡す |
| ⑥ 回答を生成 |
取得した情報をもとに回答する |
つまり、従来型RAGは「質問 → 検索 → 情報取得 → 回答」という流れが基本です。
なぜRAGが使われるのか
LLMが企業独自の情報をすべて把握しているわけではありません。RAGを利用することで、必要な情報を回答時に検索してLLMへ渡せます。
| LLMだけの場合 |
RAGを利用する場合 |
| 社内情報を把握していない |
社内文書を検索できる |
| 独自データに弱い |
独自データを参照できる |
| 根拠を確認しにくい |
参照情報を回答に利用できる |
| 情報更新への対応が難しい |
検索対象を更新できる |
そのため、RAGは社内規程検索、マニュアル検索、問い合わせ対応、ナレッジ共有などで活用できます。
RAGでは「検索」が重要になる
RAGでは、LLMの性能だけでなく「必要な情報を正しく取得できるか」が重要です。
正しい情報が文書内に存在していても、検索できなければLLMには渡りません。そのため、「どの情報を検索するか」「どの文脈をLLMへ渡すか」まで設計する必要があります。
この検索と文脈の問題が、Anthropicが従来型RAGの設計を見直す重要な背景となりました。
Anthropicが問題視した「従来RAGの限界」
Anthropicが従来型RAGの課題として注目したのが、文書を細かく分割することで「本来の文脈が失われる」という問題です。
RAGでは長い文書をチャンクと呼ばれる小さな単位に分割します。しかし、チャンクだけを見ると「誰の情報なのか」「いつの情報なのか」「何について説明しているのか」が分からなくなることがあります。
問題① チャンク化によって文脈が失われる
例えば、企業の決算資料に「売上高は前四半期から3%増加した」という情報があったとします。
元の資料を読めば企業名や対象期間が分かりますが、この一文だけがチャンクとして保存されると、検索に必要な情報が失われる可能性があります。
| 元文書では分かる情報 |
チャンクで失われやすい情報 |
| 企業名 |
どの企業の情報なのか |
| 対象期間 |
いつの情報なのか |
| 資料の種類 |
何の資料なのか |
| 前後の説明 |
何と比較しているのか |
検索対象から文脈が失われると、本来は回答に必要な情報であっても、ユーザーの質問と正しく結びつかない可能性があります。
問題② 意味検索だけでは見つけにくい情報がある
従来型RAGでは、文章の意味的な近さを利用するベクトル検索がよく使われます。
一方で、製品番号、エラーコード、型番、固有名詞などは、意味の近さよりも文字列そのものを正確に検索することが重要です。
例えば「TS-999というエラーの原因」を調べる場合、似た意味の文章より「TS-999」という文字列を含む情報を見つける必要があります。
| 検索方法 |
得意な情報 |
| ベクトル検索 |
意味や内容が近い文章 |
| キーワード検索 |
型番・固有名詞・エラーコードなど |
そのためAnthropicは、意味検索だけに依存するのではなく、キーワード検索を組み合わせる方法にも注目しました。
問題③ 一度の検索だけでは答えられない質問がある
一般的なRAGでは、ユーザーの質問に関連する情報を検索し、その結果をLLMへ渡して回答を生成します。
しかし複雑な質問では、最初の検索結果から新しい事実が分かり、その情報をもとに別の資料を調べる必要が出てくることがあります。
| 従来型RAG |
複雑な情報探索 |
| 質問する |
必要な情報を判断する |
| 関連情報を検索する |
情報を検索する |
| 上位の情報を取得する |
検索結果を確認する |
| 回答する |
必要なら追加検索する |
| - |
情報を整理して回答する |
つまり、RAGの課題は単純に「検索精度を上げる」だけでは解決できない場合があります。
重要なのは、AIにどの情報を渡すのかだけでなく、必要な情報をどのように探し、どのタイミングで追加するのかまで設計することです。
この課題に対してAnthropicが示した一つのアプローチが「Contextual Retrieval」です。
第1の転換点「Contextual Retrieval」
従来型RAGの課題に対して、Anthropicが2024年に公開したアプローチが「Contextual Retrieval」です。
ポイントは、文書をチャンクに分割してそのまま検索するのではなく、各チャンクに「元の文書の中で何を意味しているのか」という文脈を追加することです。
Contextual Retrievalとは
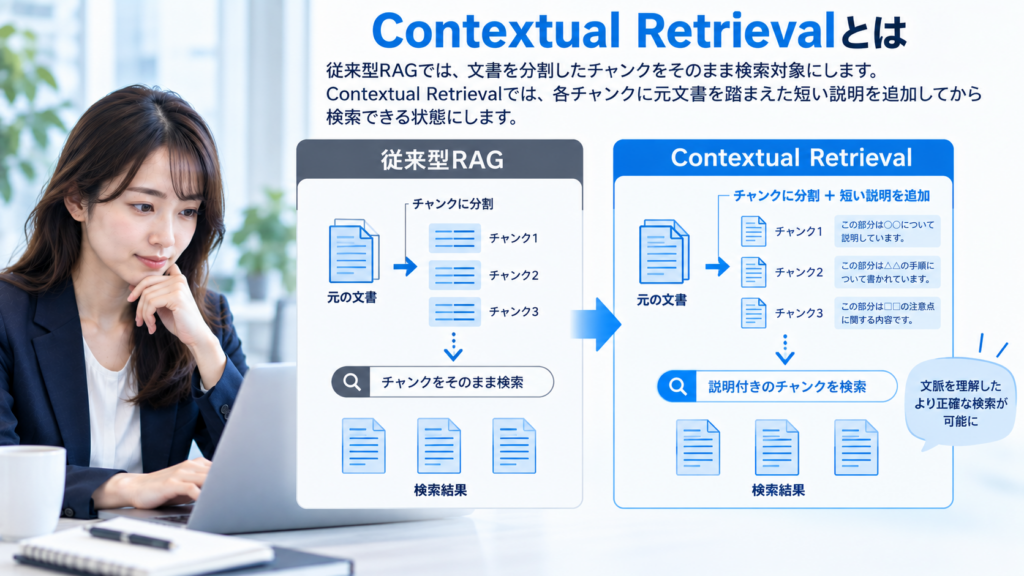
従来型RAGでは、文書を分割したチャンクをそのまま検索対象にします。Contextual Retrievalでは、各チャンクに元文書を踏まえた短い説明を追加してから検索できる状態にします。
例えば「売上高は前四半期から3%増加した」というチャンクだけでは、企業名や対象期間が分かりません。そこで「このチャンクはACME社の2023年第2四半期の業績について説明している」といった文脈を補います。
| 従来型RAG |
Contextual Retrieval |
| チャンクをそのまま保存 |
チャンクに文脈を追加 |
| 前後関係が失われやすい |
元文書との関係を残しやすい |
| チャンク単体で検索 |
文脈を含めて検索 |
| 情報が曖昧になる場合がある |
検索時の手掛かりを増やせる |
重要なのは、単純にチャンクを長くすることではありません。元文書のどこに位置し、何について説明しているのかを補うことで、必要な情報を検索しやすくします。
Contextual EmbeddingsとContextual BM25
AnthropicのContextual Retrievalでは、文脈を追加した情報をContextual EmbeddingsとContextual BM25の両方で利用します。
| 方法 |
主な役割 |
| Contextual Embeddings |
意味が近い情報を探す |
| Contextual BM25 |
キーワードが一致する情報を探す |
| Reranking |
検索候補を関連性に応じて並べ直す |
例えば「ログインできない原因」のような質問では意味検索が役立ちます。一方、「TS-999」のようなエラーコードではキーワード検索が有効です。
どちらか一方に限定せず、意味検索とキーワード検索を組み合わせることがポイントです。
Rerankingで検索結果をさらに絞り込む
Contextual Retrievalでは、取得した検索候補をRerankingによって並べ直す方法も紹介されています。
| 手順 |
内容 |
| ① 候補を取得 |
関連する情報を広めに検索する |
| ② 関連性を評価 |
質問との関連性を確認する |
| ③ 並べ替え |
重要な情報を上位にする |
| ④ LLMへ渡す |
必要性の高い情報を回答に利用する |
これにより、検索には含まれたものの、実際の回答には必要性が低い情報を減らしやすくなります。
Anthropicの検証では検索失敗率が低下
Anthropicの検証では、Contextual EmbeddingsとContextual BM25を組み合わせることで、従来のEmbeddingのみの方法と比較して検索失敗率が49%低下したと報告されています。
さらにContextual Embeddings、Contextual BM25、Rerankingを組み合わせた場合には、検索失敗率が67%低下したとしています。
ここで重要なのは、LLMそのものを変更したのではなく、LLMへ渡す前の「検索方法」と「文脈の持たせ方」を改善した点です。
Contextual RetrievalによってRAGは、単純に似ているチャンクを探す仕組みから、文脈を考慮して必要な情報を探す仕組みへと進化しました。
ただし、複雑な質問では一度の検索だけで必要な情報が揃わない場合があります。ここからAnthropicの設計思想は、さらに「AI自身が必要な情報を探す」という方向へ進んでいきます。
それでもContextual Retrievalだけでは解決できない
Contextual Retrievalによって、チャンクの文脈を保ちながら検索しやすくなりました。しかし、すべての質問を一度の検索で解決できるわけではありません。
一度の検索では情報が足りない場合がある
単純な質問なら、関連する情報を検索してLLMへ渡すだけでも回答できます。一方、複数の資料や情報源を確認する質問では、段階的な検索が必要です。
| 質問の種類 |
必要な検索 |
| 社内規程の確認 |
関連文書を検索 |
| 製品仕様の確認 |
該当資料を検索 |
| 複数資料の比較 |
複数の情報を検索・比較 |
| 複雑な調査 |
検索結果を確認しながら追加検索 |
検索結果から次の検索が必要になる
調査では、最初から必要な情報がすべて分かっているとは限りません。検索結果を読んで初めて、次に調べるべき情報が分かることがあります。
| 従来型の検索 |
段階的な検索 |
| 質問を受け取る |
質問を分析する |
| 関連情報を検索する |
必要な情報を検索する |
| 検索結果をLLMへ渡す |
検索結果を確認する |
| 回答する |
不足情報を追加検索する |
| - |
情報を統合して回答する |
「何を検索するか」もAIが判断する
ここで重要になるのが、検索内容をあらかじめ固定するのではなく、AI自身が「次に何を調べるべきか」を判断する考え方です。
質問を分析し、検索し、結果を確認し、不足していれば再び検索する。この流れによって、複数の情報を必要とする質問にも対応しやすくなります。
この「一度検索して終わるRAG」から「AIが必要に応じて情報を探す仕組み」への変化が、次に解説するAgentic Searchにつながります。
第2の転換点「Agentic Search」
Contextual Retrievalが検索精度を改善する考え方だったのに対し、Agentic Searchでは「AI自身が必要な情報を判断して探す」ことが重要になります。
一度の検索で回答するのではなく、検索結果を確認し、不足している情報があれば追加で検索します。
従来RAGとAgentic Searchの違い
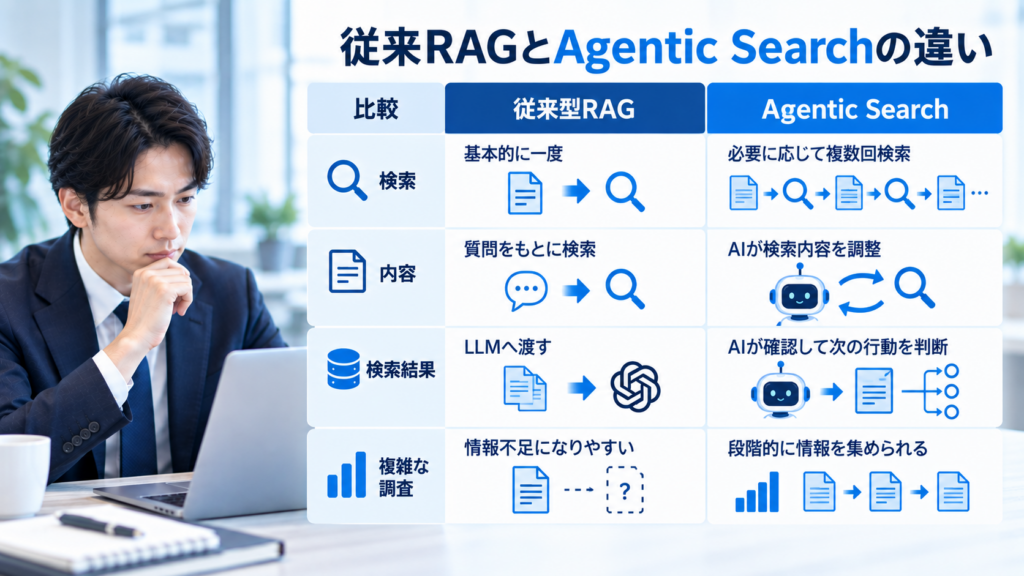
従来型RAGでは、質問に近い情報を取得してLLMへ渡す流れが基本です。Agentic Searchでは、AIが検索の進め方にも関わります。
| 比較 |
従来型RAG |
Agentic Search |
| 検索 |
基本的に一度 |
必要に応じて複数回 |
| 検索内容 |
質問をもとに検索 |
AIが検索内容を調整 |
| 検索結果 |
LLMへ渡す |
AIが確認して次の行動を判断 |
| 複雑な調査 |
情報不足になりやすい |
段階的に情報を集められる |
検索・確認・再検索を繰り返す
Agentic Searchでは、最初からすべての検索条件を決める必要はありません。取得した情報をもとに、次に必要な情報を判断します。
| 手順 |
AIの動き |
| ① 分析 |
質問に必要な情報を考える |
| ② 検索 |
必要な情報を探す |
| ③ 確認 |
情報が十分か判断する |
| ④ 再検索 |
不足していれば追加で探す |
| ⑤ 回答 |
集めた情報を整理する |
複数の情報源を横断できる
Agentic Searchでは、文書検索だけでなく、Web、ファイル、データベース、外部ツールなどを目的に応じて使い分ける設計も可能になります。
例えば企業調査では、最初に企業情報を確認し、その結果から市場データや競合情報を追加で調べるといった流れを作れます。
複数のAIで調査を分担する方法もある
Anthropicが公開したResearchシステムでは、中心となるAIが調査方針を決め、複数のAIに情報収集を分担させる構成も採用されています。
| 役割 |
内容 |
| 中心となるAI |
調査方針を決める |
| 担当AI |
それぞれ情報を調査する |
| 中心となるAI |
結果を整理して回答する |
この変化によって、RAGは「関連情報を検索する仕組み」から、「AIが必要な情報を判断しながら集める仕組み」へ広がっています。
そして、この考え方をさらに広げると、重要になるのが「AIにどの情報を与えるか」を設計するContext Engineeringです。
Anthropicが重視する「Context Engineering」
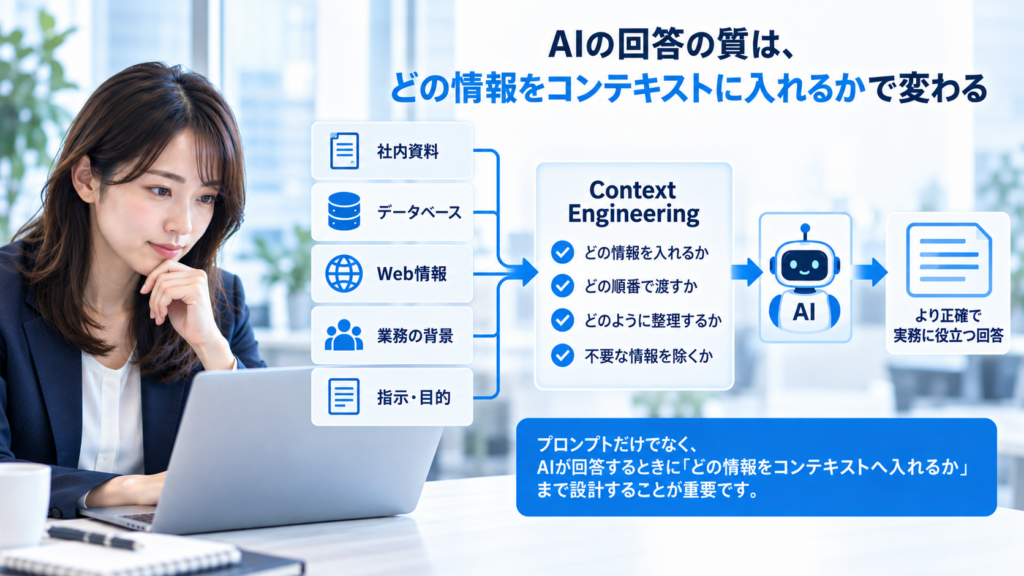
Anthropicの設計思想を理解するうえで重要なのが「Context Engineering」です。
ポイントは、プロンプトだけを工夫するのではなく、AIが回答するときに「どの情報をコンテキストへ入れるか」まで設計することです。
Prompt Engineeringとの違い
Prompt Engineeringは、AIへの指示の書き方を改善する考え方です。Context Engineeringでは、指示だけでなく、検索結果やツール、会話履歴なども含めて設計します。
| 比較 |
Prompt Engineering |
Context Engineering |
| 中心 |
指示文 |
AIに渡す情報全体 |
| 対象 |
プロンプト |
検索・ツール・履歴・外部情報など |
| 目的 |
指示を正しく伝える |
必要な情報を適切に与える |
RAGもContextを作る手段の一つ
Context Engineeringの視点では、RAGはAIへ必要な情報を渡すための手段の一つと考えられます。
| 情報 |
役割 |
| プロンプト |
目的や指示を伝える |
| RAG |
関連文書を取得する |
| ツール |
外部の情報や機能を利用する |
| 会話履歴 |
これまでのやり取りを保持する |
| 検索結果 |
必要な最新情報などを補う |
長いContext Windowだけでは解決しない
LLMが扱える情報量が増えても、すべての情報を入れればよいとは限りません。
大量の情報を与えると、重要な情報と不要な情報が混ざります。そのため、必要な情報を選び、適切なタイミングで追加する設計が重要です。
| 考え方 |
特徴 |
| すべて入れる |
不要な情報も増えやすい |
| RAGで検索する |
関連情報を絞って取得する |
| AIが必要時に検索する |
状況に応じて情報を追加する |
重要なのは「何を入れるか」
RAGの目的は、検索すること自体ではありません。最終的な目的は、AIが回答や判断に必要な情報を取得できる状態を作ることです。
この視点に立つと、「どの検索技術を使うか」だけでなく、「何を、いつ、どの程度AIへ渡すか」が重要になります。
AnthropicのRAGに対する考え方の変化は、検索中心の設計から、AIが扱うContext全体を設計する方向への広がりとして捉えることができます。
「AIを導入したい」「業務を変えたい」でも、何から始めるべきか分からない。
Start Challenge Consultingでは、AI・DX活用から業務改革、データ活用、システム導入まで、
企業ごとの課題に合わせて幅広く支援しています。
自社の課題に、どのような支援ができるのか確認してみませんか?
自社に合った支援内容を見てみる
AnthropicのRAG設計思想はどう変わったのか
AnthropicのRAGに対する考え方は、「関連情報を検索する」だけでなく、「AIが必要な文脈を適切に取得する」という方向へ広がっています。
変化を整理すると、従来型RAG、Contextual Retrieval、Agentic Searchの3段階で理解できます。
① 従来型RAG|関連する情報を検索する
従来型RAGでは、質問と意味が近いチャンクを検索し、上位の情報をLLMへ渡す方法が中心です。
シンプルで使いやすい一方、チャンク化による文脈の欠落や、一度の検索では情報が不足する課題があります。
② Contextual Retrieval|文脈を含めて検索する
Contextual Retrievalでは、各チャンクに元文書の文脈を補い、意味検索とキーワード検索を組み合わせます。
「似ている情報を探す」だけでなく、「その情報が何について書かれているのか」まで検索に利用する考え方です。
③ Agentic Search|AI自身が必要な情報を探す
Agentic Searchでは、AIが質問を分析し、必要な情報を検索します。情報が不足していれば、検索内容を変えて追加調査します。
検索方法を固定するのではなく、目的に応じて情報の探し方を変える点が大きな違いです。
| 段階 |
中心となる考え方 |
特徴 |
| 従来型RAG |
関連情報を検索 |
質問に近いチャンクを取得 |
| Contextual Retrieval |
文脈を含めて検索 |
チャンクに元文書の情報を補う |
| Agentic Search |
AIが情報を探索 |
必要に応じて検索を繰り返す |
| Context Engineering |
文脈全体を設計 |
検索・ツール・履歴などを統合 |
つまり、設計の中心が「どう検索するか」から「AIに必要な情報をどう届けるか」へ広がっていると整理できます。
ただし、従来型RAGが不要になったわけではありません。用途やデータの特徴によって、適切な方法を選ぶことが重要です。
企業のRAG開発は今後どう変えるべきか
これからのRAG開発では、すべてのデータを同じ方法で検索するのではなく、情報の種類や目的に合わせて検索方法を選ぶことが重要です。
例えば、文章の意味から探したい場合はベクトル検索、型番や固有名詞ではキーワード検索、複雑な調査ではAgentic Searchが候補になります。
| データ・目的 |
検討する方法 |
| 意味が近い文章を探す |
ベクトル検索 |
| 型番・固有名詞を探す |
キーワード検索 |
| 文脈が重要な文書 |
Contextual Retrieval |
| 複数情報を調査する |
Agentic Search |
| 構造化された数値 |
データベース検索 |
また、RAGの評価では「検索できたか」だけでなく、最終的な回答まで確認する必要があります。
| 確認項目 |
確認すること |
| 検索精度 |
必要な情報を取得できたか |
| 回答精度 |
正しい回答になっているか |
| 根拠 |
参照情報と回答が一致しているか |
| 速度 |
回答までに時間がかかりすぎないか |
| コスト |
検索や生成の負担が適切か |
PoCでは、一つの方式だけを試すのではなく、同じ質問を使って複数の検索方法を比較すると違いを確認しやすくなります。
| 比較方式 |
確認ポイント |
| ベクトル検索 |
基本的な検索精度 |
| ベクトル+キーワード検索 |
検索方法を組み合わせた効果 |
| Contextual Retrieval |
文脈を追加した場合の違い |
| Agentic Search |
複雑な質問への対応 |
重要なのは、最新の方法を選ぶことではありません。自社のデータと質問に対して、必要な情報を正しく取得できる方法を選ぶことです。
RAG・Long Context・Agentic Searchの判断基準
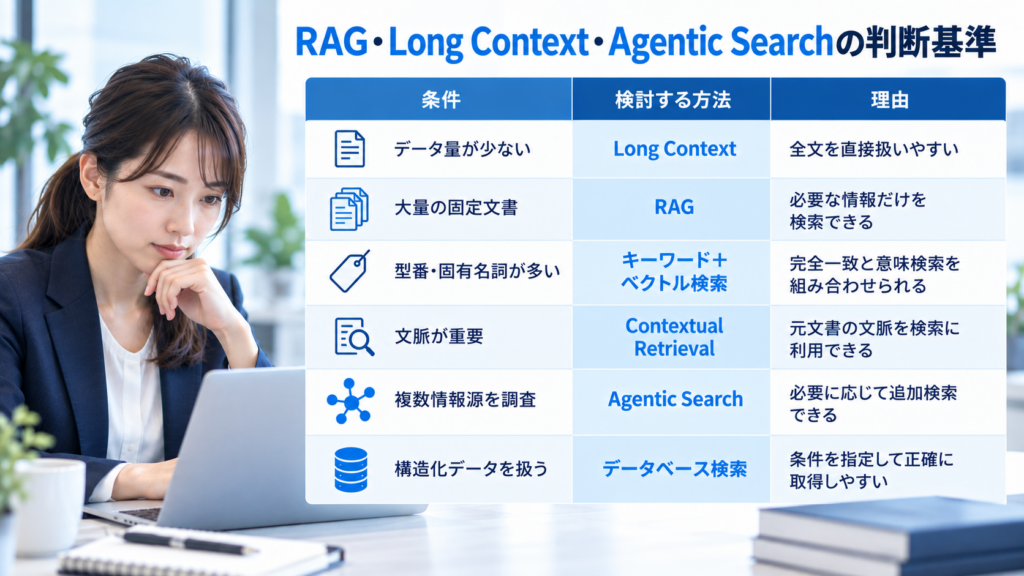
RAG、Long Context、Agentic Searchには、それぞれ得意な用途があります。重要なのは、一つの方法に統一するのではなく、データ量や質問の複雑さに合わせて選ぶことです。
| 条件 |
検討する方法 |
理由 |
| データ量が少ない |
Long Context |
全文を直接扱いやすい |
| 大量の固定文書 |
RAG |
必要な情報だけを検索できる |
| 型番・固有名詞が多い |
キーワード+ベクトル検索 |
完全一致と意味検索を組み合わせられる |
| 文脈が重要 |
Contextual Retrieval |
元文書の文脈を検索に利用できる |
| 複数情報源を調査 |
Agentic Search |
必要に応じて追加検索できる |
| 構造化データを扱う |
データベース検索 |
条件を指定して正確に取得しやすい |
例えば、数ページの資料を確認するだけなら、必ずしもRAGを構築する必要はありません。一方、大量の社内文書から必要な情報を探す場合はRAGが有力な選択肢になります。
さらに、複数の資料やWeb、データベースを横断して調査する場合は、AIが必要な情報を判断しながら検索するAgentic Searchが適しています。
「どの技術が新しいか」ではなく、「どの情報を、どの方法でAIへ渡すのが適切か」を基準に選ぶことが重要です。
「AIを導入したい」「業務を変えたい」でも、何から始めるべきか分からない。
Start Challenge Consultingでは、AI・DX活用から業務改革、データ活用、システム導入まで、
企業ごとの課題に合わせて幅広く支援しています。
自社の課題に、どのような支援ができるのか確認してみませんか?
自社に合った支援内容を見てみる
Anthropicの変化から分かる「RAGの未来」
Anthropicの変化を見ると、RAGがなくなるのではなく、AIへ必要な情報を渡すための「一つの手段」になっていくと考えられます。
従来は、質問に近い情報を検索してLLMへ渡すことが中心でした。現在は、文脈を補った検索や、AI自身による追加検索など、情報の取得方法が広がっています。
| 変化 |
考え方 |
| 従来型RAG |
関連する情報を検索する |
| Contextual Retrieval |
文脈を含めて検索する |
| Agentic Search |
AIが必要な情報を探す |
| Context Engineering |
AIに渡す情報全体を設計する |
今後は「どのベクトルデータベースを使うか」だけではなく、検索、ツール、会話履歴、外部データなどをどう組み合わせるかが重要になります。
つまり、RAG開発の中心は「検索システムを作ること」から「AIが必要な文脈へアクセスできる仕組みを作ること」へ広がっていくと考えられます。
よくある質問
Q1. RAGとは何ですか?
RAGとは、AIが回答する前に外部の文書やデータを検索し、取得した情報をもとに回答を生成する仕組みです。
Q2. なぜRAGが利用されているのですか?
LLMだけでは把握できない社内文書や独自データなどを検索し、回答時の情報として利用できるためです。
Q3. 従来型RAGはどのような仕組みですか?
文書を小さなチャンクに分割して検索できる状態にし、質問と関連性の高い情報を取得してLLMへ渡す仕組みが基本です。
Q4. RAGではなぜ検索が重要なのですか?
正しい情報が文書内にあっても、検索段階で取得できなければLLMへ渡せないためです。回答品質だけでなく、必要な情報を取得できるかが重要になります。
Q5. AnthropicはRAGを廃止しようとしているのですか?
いいえ。RAGを否定するのではなく、AIに必要な情報をどのように取得して渡すかという、より広い設計へ考え方を発展させています。
Q6. Anthropicが指摘した従来型RAGの課題は何ですか?
代表的な課題は、文書をチャンクへ分割することで、本来の文脈が失われる場合があることです。
Q7. チャンクとは何ですか?
長い文書を検索しやすくするために分割した、小さな文章単位のことです。RAGではチャンク単位で情報を検索する方法がよく使われます。
Q8. チャンク化すると、なぜ文脈が失われるのですか?
文章だけが切り出されることで、企業名、対象期間、資料の種類、前後の説明などがチャンクに含まれなくなる場合があるためです。
Q9. ベクトル検索とは何ですか?
文章の意味的な近さを利用して、質問と関連性の高い情報を探す検索方法です。
Q10. ベクトル検索だけでは不十分な場合がありますか?
あります。型番、エラーコード、固有名詞など、文字列そのものが重要な情報では、キーワード検索が有効な場合があります。
Q11. Contextual Retrievalとは何ですか?
各チャンクに元文書の文脈を補ってから検索対象にするAnthropicのアプローチです。チャンク単体では失われやすい情報を検索時の手掛かりとして利用します。
Q12. Contextual Retrievalと従来型RAGの違いは何ですか?
従来型RAGがチャンクをそのまま検索するのに対し、Contextual Retrievalでは元文書との関係を示す文脈をチャンクへ追加して検索します。
Q13. Contextual Embeddingsとは何ですか?
元文書の文脈を補ったチャンクを利用し、意味的に関連する情報を探す方法です。
Q14. Contextual BM25とは何ですか?
文脈を補った情報に対して、キーワードを使って関連する情報を探す方法です。型番や固有名詞などの検索にも役立ちます。
Q15. Rerankingとは何ですか?
検索で取得した候補を質問との関連性に応じて改めて評価し、重要な情報を上位へ並べ直す方法です。
Q16. AnthropicのContextual Retrievalではどの程度改善しましたか?
Anthropicの検証では、Contextual EmbeddingsとContextual BM25の組み合わせで検索失敗率が49%低下し、Rerankingまで組み合わせた場合には67%低下したと報告されています。
Q17. Contextual Retrievalだけですべての質問に対応できますか?
すべてではありません。複数の資料を確認する質問や、検索結果をもとに追加調査が必要になる質問では、一度の検索だけでは情報が不足する場合があります。
Q18. Agentic Searchとは何ですか?
AI自身が必要な情報を判断して検索し、結果を確認しながら必要に応じて追加検索する考え方です。
Q19. Agentic Searchと従来型RAGの違いは何ですか?
従来型RAGは質問に関連する情報を検索して回答する流れが基本ですが、Agentic SearchではAIが検索結果を確認し、次に何を調べるかも判断します。
Q20. Agentic Searchはどのような質問に向いていますか?
複数の資料や情報源を横断する調査など、一度の検索では必要な情報が揃いにくい質問に適しています。
Q21. Agentic Searchでは文書以外も検索できますか?
設計によっては、文書だけでなくWeb、ファイル、データベース、外部ツールなど複数の情報源を使い分けることができます。
Q22. AnthropicのResearchシステムでは複数のAIを使うのですか?
Anthropicが公開したResearchシステムでは、中心となるAIが調査方針を決め、複数のAIが情報収集を分担し、その結果を整理する構成が採用されています。
Q23. Context Engineeringとは何ですか?
AIが回答や判断を行うときに、どの情報をコンテキストへ入れるかを設計する考え方です。
Q24. Prompt EngineeringとContext Engineeringは何が違いますか?
Prompt Engineeringが主に指示文を対象とするのに対し、Context Engineeringでは検索結果、ツール、会話履歴、外部情報などAIに渡す情報全体を考えます。
Q25. Context Windowが大きければRAGは不要ですか?
必ずしも不要ではありません。データ量が少なければ全文を扱う方法もありますが、大量の文書では必要な情報だけを検索するRAGが選択肢になります。
Q26. 大量の情報をすべてLLMへ渡せばよいのではありませんか?
大量の情報には不要な内容も含まれるため、すべてを渡すことが常に適切とは限りません。必要な情報を選んで渡す設計が重要です。
Q27. 企業はどのRAG方式を選べばよいですか?
データ量、文書の特徴、質問の複雑さに合わせて選ぶことが重要です。大量の固定文書ならRAG、文脈が重要ならContextual Retrieval、複雑な調査ならAgentic Searchなどが候補になります。
Q28. RAGのPoCでは何を比較すればよいですか?
同じ質問を使い、ベクトル検索、ベクトル+キーワード検索、Contextual Retrieval、Agentic Searchなどを比較すると違いを確認しやすくなります。
Q29. RAGを評価するときは何を確認すべきですか?
必要な情報を取得できたかだけでなく、最終回答の正確性、根拠との一致、回答速度、コストなども確認することが重要です。
Q30. AnthropicのRAG設計思想の変化で最も重要な点は何ですか?
「どう検索するか」だけでなく、「AIが必要な情報を、必要なタイミングで取得できる状態をどう作るか」へ設計の中心が広がっている点です。RAGはContext Engineeringを構成する重要な手段の一つとして位置づけられます。
まとめ|Anthropicが変えたのはRAGではなく「Contextの考え方」
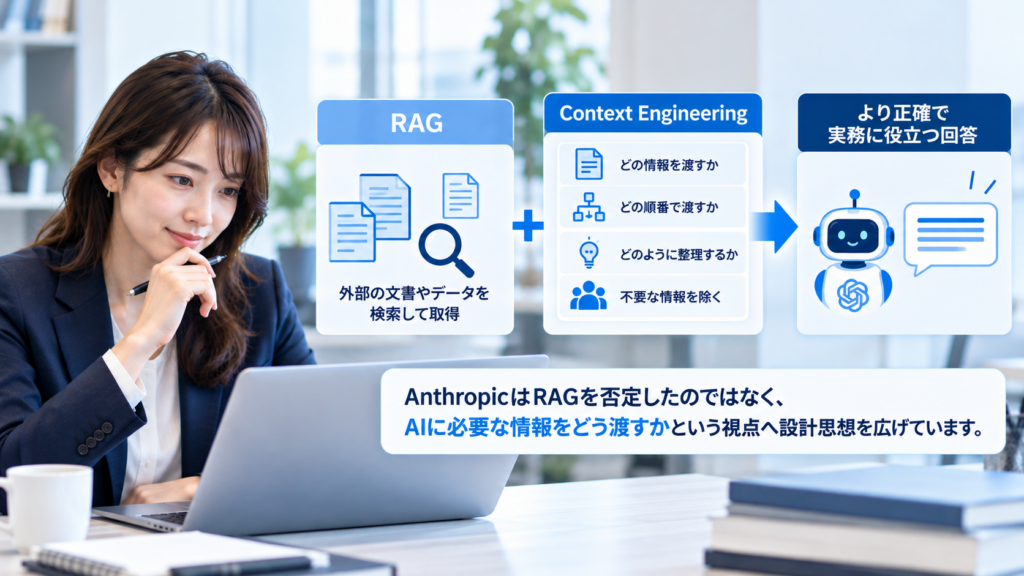
AnthropicはRAGを否定したのではなく、AIに必要な情報をどう渡すかという視点へ設計思想を広げています。
従来型RAGでは、チャンク化による文脈の欠落や、一度の検索だけでは必要な情報を集めきれない課題がありました。
| ポイント |
変化 |
| 従来型RAG |
関連するチャンクを検索 |
| Contextual Retrieval |
文脈を補って検索 |
| Agentic Search |
AIが必要な情報を探索 |
| Context Engineering |
AIに渡す情報全体を設計 |
これから重要になるのは、最新の検索技術を導入することではなく、自社のデータや目的に合わせて必要な情報を適切にAIへ届けることです。
RAGはなくなるのではなく、Context Engineeringを構成する重要な手段の一つとして活用されていくと考えられます。
SUPERVISED BY
平出 大輔
株式会社Start Challenge Consulting
代表取締役CEO/AI・DXコンサルタント
約10年間、外資系コンサルティングファームにて企業のDX推進・業務改革・AI活用支援など数多くのプロジェクトを担当。これまで培った知見をもとに株式会社Start Challenge Consultingを創業し、生成AI、データ活用、DX推進を軸とした経営・業務改革支援を行っています。
「仕事=生きがい・楽しさ」という価値観を大切にし、クライアントと同じ目線で未来を創る真のパートナーとして、日本を代表するコンサルティングファームを目指しています。