金融業界では、生成AIや機械学習を活用し、業務効率化や顧客対応、社内情報の検索、リスク管理などを高度化する動きが広がっています。
一方、金融AIの導入では「どのAIを使うか」に注目が集まりやすく、AIが利用するデータの品質が見落とされることがあります。
どれだけ高性能なAIでも、元となるデータに問題があれば、回答や分析、判断支援の品質に影響する可能性があります。特に確認したいのは、次のような問題です。
- 顧客情報や取引情報に誤りがある
- 必要な項目が欠損している
- 同じ顧客やデータが重複している
- 古い規程や商品情報が残っている
- システムごとにデータの定義が異なる
- AIが参照してよいデータの範囲が整理されていない
たとえば、社内規程を検索するAIに古い文書と最新の文書が混在していれば、古い情報をもとに回答する可能性があります。また、顧客データが複数のシステムに分散していれば、分析結果にズレが生じる原因にもなります。
特に生成AIやRAG、AIエージェントでは、AIがさまざまなデータを検索・参照して業務を支援します。そのため、AIモデルの性能だけでなく、「正しいデータを適切に利用できる状態」を作ることが重要です。
この記事では、金融AI導入で見落とされやすいデータ品質の問題から、品質を評価する指標、データ整備の進め方、PoCで確認すべきポイント、データガバナンスまで分かりやすく解説します。
金融AIでは、なぜデータ品質が重要なのか
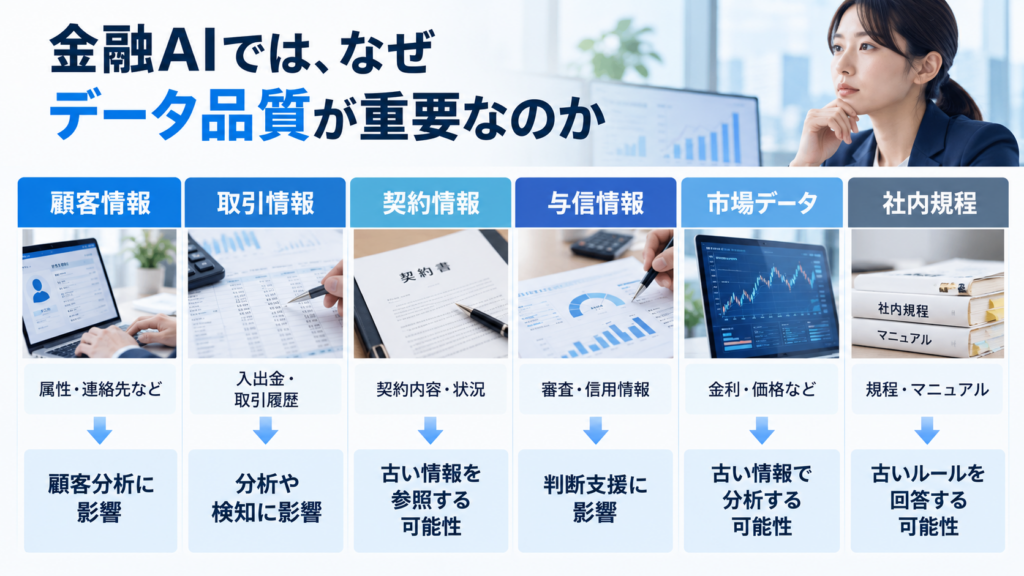
金融AIの精度は、AIモデルの性能だけで決まりません。AIが利用するデータに誤りや欠損、古い情報があれば、回答や分析結果にも影響します。
特に金融業務では、顧客情報や取引履歴、契約情報など、重要なデータを扱います。そのため、AI導入と同時にデータ品質を確認することが重要です。
| データ |
主な内容 |
品質に問題がある場合 |
| 顧客情報 |
属性・連絡先など |
顧客分析に影響 |
| 取引情報 |
入出金・取引履歴 |
分析や検知に影響 |
| 契約情報 |
契約内容・状況 |
古い情報を参照する可能性 |
| 与信情報 |
審査・信用情報 |
判断支援に影響 |
| 市場データ |
金利・価格など |
古い情報で分析する可能性 |
| 社内規程 |
規程・マニュアル |
古いルールを回答する可能性 |
たとえば、同じ顧客が複数登録されていれば、集計や顧客分析にズレが生じます。また、古い社内規程が残っていれば、RAGや生成AIが古い情報を参照する可能性があります。
金融AIでは、データ量だけでなく、正確性・完全性・一貫性・鮮度などを確認することが重要です。
つまり、金融AIを安定して活用するには、「どのAIを使うか」だけではなく、「どのデータを、どの状態で使わせるか」まで設計する必要があります。
金融AIで起こりやすい7つのデータ品質問題
金融AIでは、データの量が多くても、その品質が十分とは限りません。特に複数のシステムや長期間蓄積されたデータを利用する場合、さまざまな問題がAIの回答や分析に影響します。
| データ品質の問題 |
具体的な状態 |
AIへの影響 |
| ① データのサイロ化 |
部門やシステムごとにデータが分散 |
必要な情報をまとめて参照できない |
| ② 定義の不統一 |
同じ項目でも意味や集計条件が異なる |
分析結果にズレが生じる |
| ③ データの老朽化 |
古い顧客情報や規程が残っている |
古い情報をもとに回答する |
| ④ データの欠損 |
必要な項目が入力されていない |
十分な情報で分析できない |
| ⑤ データの重複 |
同じ顧客や取引が複数登録されている |
集計や顧客分析に影響する |
| ⑥ 表記・入力ルールの不統一 |
略称や表記方法が統一されていない |
検索漏れや分類ミスにつながる |
| ⑦ アクセス権の不備 |
AIの参照範囲が適切に設定されていない |
本来参照すべきでない情報を利用する可能性 |
たとえば、顧客情報が営業システムと契約管理システムに分散し、それぞれ異なる顧客IDで管理されていると、AIが同じ顧客として扱えない場合があります。
また、社内規程やマニュアルをRAGで検索する場合、古い文書が検索対象に残っていると、AIが現在とは異なるルールを回答する可能性があります。
さらに注意したいのがアクセス権です。AIが利用できるデータの範囲を整理せずにシステムを接続すると、本来その利用者が閲覧できない情報までAIが参照するリスクがあります。
金融AIを導入する際は、こうした問題をAI導入後に修正するのではなく、データを接続する段階で確認することが重要です。
なぜ金融AIではデータ品質の問題が表面化しやすいのか
金融機関では、これまでも大量の顧客情報や取引情報を扱ってきました。それでもデータ品質の問題が業務上大きな問題にならなかったケースがあるのは、担当者が経験や業務知識によってデータを補正していたためです。
たとえば、担当者であれば「このコードは旧商品のこと」「このデータは更新前の情報」「この顧客は別システムにも登録されている」と判断できることがあります。
しかし、AIが同じように判断できるとは限りません。AIが利用するデータにこうした背景やルールが反映されていなければ、そのまま検索や分析に利用する可能性があります。
| 従来の業務 |
AIを活用する業務 |
| 担当者がデータを確認する |
AIが大量のデータを処理する |
| 経験から例外を判断する |
明確なルールやデータが必要 |
| 不自然な数値に気づける |
元データを前提に処理する場合がある |
| 必要な情報を人が選ぶ |
AIが検索・取得する |
特にRAGやAIエージェントでは、AIが複数のデータを自動的に検索・参照するため、これまで人が補っていた曖昧さが表面化しやすくなります。
そのため、金融AIの導入では、担当者が持っている暗黙のルールを整理し、データの定義や更新方法、利用条件として明確にすることが重要です。
AI導入は単なるシステム導入ではなく、これまで人が補ってきた業務知識やデータ管理のルールを整理する機会でもあります。
データ品質が悪いまま金融AIを導入すると何が起こるのか
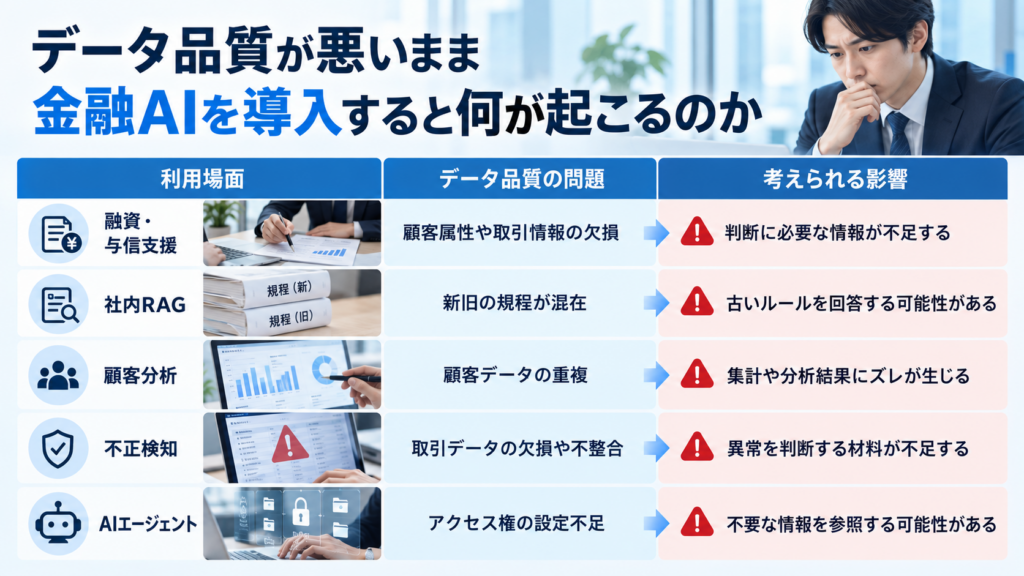
データ品質に問題があるまま金融AIを導入すると、AIの回答や分析だけでなく、その結果を利用する業務にも影響する可能性があります。
特に金融AIでは、顧客情報、取引情報、契約情報、社内規程など複数のデータを利用するため、元データの問題がAIの利用段階で表面化することがあります。
| 利用場面 |
データ品質の問題 |
考えられる影響 |
| 融資・与信支援 |
顧客属性や取引情報の欠損 |
判断に必要な情報が不足する |
| 社内RAG |
新旧の規程が混在 |
古いルールを回答する可能性がある |
| 顧客分析 |
顧客データの重複 |
集計や分析結果にズレが生じる |
| 不正検知 |
取引データの欠損や不整合 |
異常を判断する材料が不足する |
| AIエージェント |
アクセス権の設定不足 |
不要な情報を参照する可能性がある |
たとえば、社内RAGの回答が間違っている場合、必ずしも生成AIそのものが原因とは限りません。検索対象に古い規程が残っている、最新版を判別できない、必要な文書が登録されていないといったデータ側の問題も考えられます。
顧客分析でも同様です。同じ顧客が複数のIDで登録されていれば、AIモデルが正常に動いていても、元データをもとにした集計結果が実態とずれる可能性があります。
そのため、AIの精度が低いときに、すぐモデルやプロンプトだけを変更するのは適切とは限りません。AI側の問題とデータ側の問題を分けて確認することが重要です。
金融AIでは、「AIが正しく動いているか」だけでなく、「AIが正しいデータを使っているか」まで確認することで、問題の原因を特定しやすくなります。
金融AIに必要なデータ品質をどう評価するか
金融AIで利用するデータは、「多いか少ないか」だけで評価するものではありません。AIが適切に利用できる状態かどうかを、複数の視点から確認する必要があります。
特に重要なのが、正確性・完全性・一貫性・鮮度・一意性・追跡可能性・アクセス適切性の7つです。
| 評価項目 |
確認する内容 |
確認指標の例 |
| 正確性 |
データの内容が正しいか |
エラー率 |
| 完全性 |
必要な項目が揃っているか |
欠損率 |
| 一貫性 |
システム間で内容や定義が一致しているか |
不一致率 |
| 鮮度 |
必要なタイミングで最新の状態か |
最終更新日・更新遅延 |
| 一意性 |
同じデータが重複していないか |
重複率 |
| 追跡可能性 |
データの出所や変更履歴を確認できるか |
出所・更新履歴の確認 |
| アクセス適切性 |
必要な利用者やAIだけが参照できるか |
権限設定・アクセス記録 |
すべてのデータに同じ品質基準を設定する必要はありません。顧客情報、取引情報、社内規程、市場データなど、AIの利用目的によって重視する項目は異なります。
たとえば、社内規程を検索するAIでは、文書の正確性や鮮度、最新版を識別できることが重要です。一方、顧客分析では、欠損や重複、システム間のデータ不一致なども確認する必要があります。
金融AIのデータ品質は、感覚的に「きれいなデータか」を判断するのではなく、利用目的に合わせて確認項目を決め、継続的に測定できる状態にすることが重要です。
AIの問題とデータの問題をどう切り分けるか
金融AIの回答や分析に問題があった場合、すぐにAIモデルの性能不足と判断するのは適切ではありません。原因が、AIではなく元データにある場合もあります。
重要なのは、「AIがどのデータを参照し、どの段階で問題が発生したのか」を確認することです。
| 発生している問題 |
考えられる原因 |
確認するポイント |
| 古い情報を回答する |
データの更新不足 |
更新日・検索対象文書 |
| 必要な情報を取得できない |
データ欠損・検索精度 |
元データ・検索結果 |
| 顧客情報を取り違える |
重複・名寄せ不足 |
顧客ID・重複データ |
| 数値が一致しない |
データ定義の不統一 |
集計条件・項目定義 |
| データは正しいが回答が不適切 |
AIモデル・指示方法 |
プロンプト・モデル・出力条件 |
たとえば、RAGが古い社内規程を回答した場合、生成AIを変更する前に、検索対象に旧版が残っていないか、最新版を適切に取得できているかを確認します。
一方、正しいデータを取得できているにもかかわらず回答内容が不適切であれば、プロンプトやモデル、回答生成の設定などAI側を確認します。
このように原因を切り分けることで、必要のないモデル変更を避け、データ整備や検索設定など、本当に改善すべき部分を特定しやすくなります。
金融AI導入前に行うべきデータ整備5ステップ
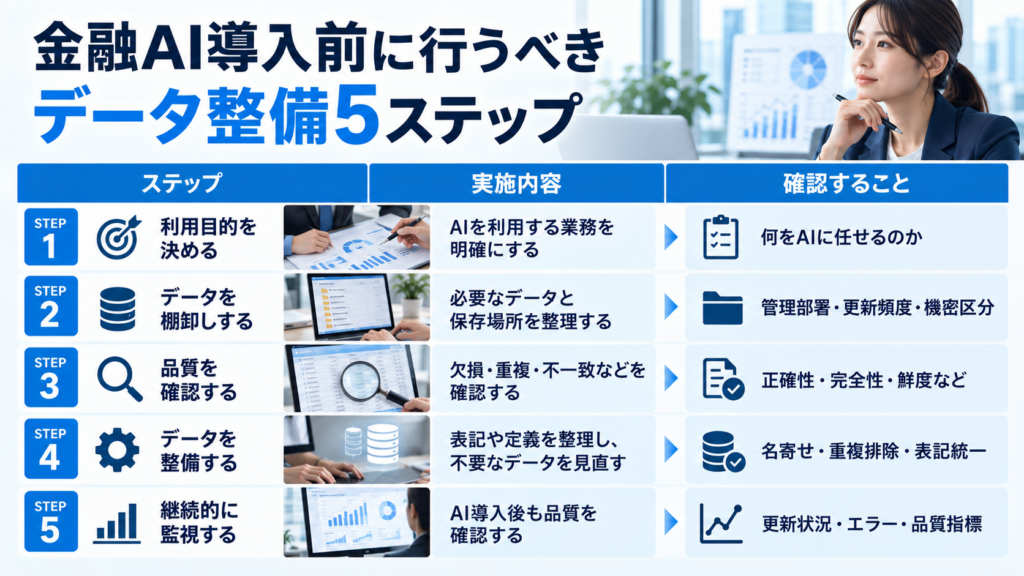
金融AIを導入するからといって、最初から社内にあるすべてのデータを整理する必要はありません。まずAIを利用する業務を決め、その業務に必要なデータから整備することが重要です。
| ステップ |
実施内容 |
確認すること |
| STEP1 利用目的を決める |
AIを利用する業務を明確にする |
何をAIに任せるのか |
| STEP2 データを棚卸しする |
必要なデータと保存場所を整理する |
管理部署・更新頻度・機密区分 |
| STEP3 品質を確認する |
欠損・重複・不一致などを確認する |
正確性・完全性・鮮度など |
| STEP4 データを整備する |
表記や定義を整理し、不要なデータを見直す |
名寄せ・重複排除・表記統一 |
| STEP5 継続的に監視する |
AI導入後も品質を確認する |
更新状況・エラー・品質指標 |
最初に行うのは、AIの利用目的を明確にすることです。社内問い合わせ、顧客分析、融資支援など、目的によって必要なデータや求められる品質は異なります。
次に、対象となるデータがどこにあり、誰が管理し、どの程度の頻度で更新されているのかを整理します。そのうえで欠損や重複、古い情報、システム間の不一致などを確認します。
問題が見つかった場合は、表記の統一や名寄せ、重複データの整理などを行います。社内規程をRAGで利用する場合は、最新版と旧版を区別できる状態にすることも重要です。
また、データ整備はAI導入前に一度行えば終わりではありません。顧客情報や取引情報、規程などは継続的に更新されるため、AI導入後も品質を確認できる仕組みを整える必要があります。
利用目的から逆算して必要なデータを整備し、その品質を継続的に管理することが、金融AIを安定して運用するための基本となります。
金融業務へのAI活用を検討しているものの、セキュリティや精度に不安はありませんか?
金融業界では、審査業務やリスク分析、問い合わせ対応、コンプライアンス対応など、AIを活用できる業務が増えています。一方で、セキュリティやガバナンス、法規制への対応も欠かせません。
当社では、金融業界の業務課題に合わせたAI導入戦略の立案から、ツール選定、
PoC、運用・定着まで一貫してサポートします。
「金融業務にAIをどう活用すべきか相談したい」という企業様は、お気軽にご相談ください。
金融AIについて相談する
PoCではAI精度だけでなくデータ品質も評価する
金融AIのPoCでは、回答精度や業務時間の短縮だけでなく、AIが利用するデータの品質も確認することが重要です。
AIの回答に問題があった場合、モデルの性能だけでなく、必要なデータが存在するか、最新情報を取得できているか、重複や不一致がないかまで確認します。
| 評価項目 |
確認すること |
| AI回答の正確性 |
期待する内容を回答できているか |
| 検索精度 |
必要なデータや文書を取得できているか |
| 欠損 |
必要な項目が揃っているか |
| 重複 |
同じ顧客や情報が重複していないか |
| 鮮度 |
必要なデータが最新の状態か |
| データの一貫性 |
システム間で定義や内容が一致しているか |
| 人による修正 |
AIの結果をどの部分で修正したか |
たとえば、社内規程を検索するAIで回答に誤りがあった場合は、回答だけを見るのではなく、AIがどの文書を取得したのかを確認します。正しい文書を取得できていなければ、検索方法やデータ側に改善点があると考えられます。
一方、正しいデータを取得できているにもかかわらず回答が不適切であれば、モデルやプロンプトなどAI側を見直します。
PoCでは「AIが正解したか」だけで評価せず、「どのデータを使い、どこで問題が発生したか」まで確認することで、本番導入前に改善すべきポイントを明確にできます。
金融AIのデータ品質を支えるデータガバナンス
金融AIのデータ品質を維持するには、データを整備するだけでなく、誰が管理し、どのようなルールでAIに利用させるかを明確にする必要があります。そのために重要なのがデータガバナンスです。
AI開発部門だけにデータ管理を任せるのではなく、業務部門、IT部門、リスク管理部門などが役割を分担し、データの品質や利用範囲を管理します。
| 関係部門 |
主な役割 |
| 業務部門 |
データの意味や業務上のルールを整理する |
| IT・データ管理部門 |
データ基盤、品質、更新方法を管理する |
| AI開発・運用部門 |
AIが利用するデータや処理方法を管理する |
| リスク管理・コンプライアンス部門 |
データ利用やアクセス権のリスクを確認する |
| 経営層 |
AI・データ活用の方針や責任体制を決める |
特に重要なのが、データの管理責任を明確にすることです。「誰が更新するのか」「誤りが見つかった場合に誰が修正するのか」が曖昧な状態では、AI導入後にデータ品質を維持することが難しくなります。
また、AIが参照できるデータの範囲も管理する必要があります。利用者の権限に応じて参照範囲を設定し、必要に応じてアクセス履歴やデータの利用状況を確認できる状態にします。
データは継続的に追加・更新されるため、ガバナンスも導入時だけの対応ではありません。データの更新、AIでの利用、出力結果の確認、問題の修正までを継続して管理することが重要です。
金融AIを安定して運用するには、AIモデルだけを管理するのではなく、そのAIが利用するデータまで含めて責任体制と管理ルールを整える必要があります。
AIエージェント時代は「データ+AIガバナンス」が重要になる
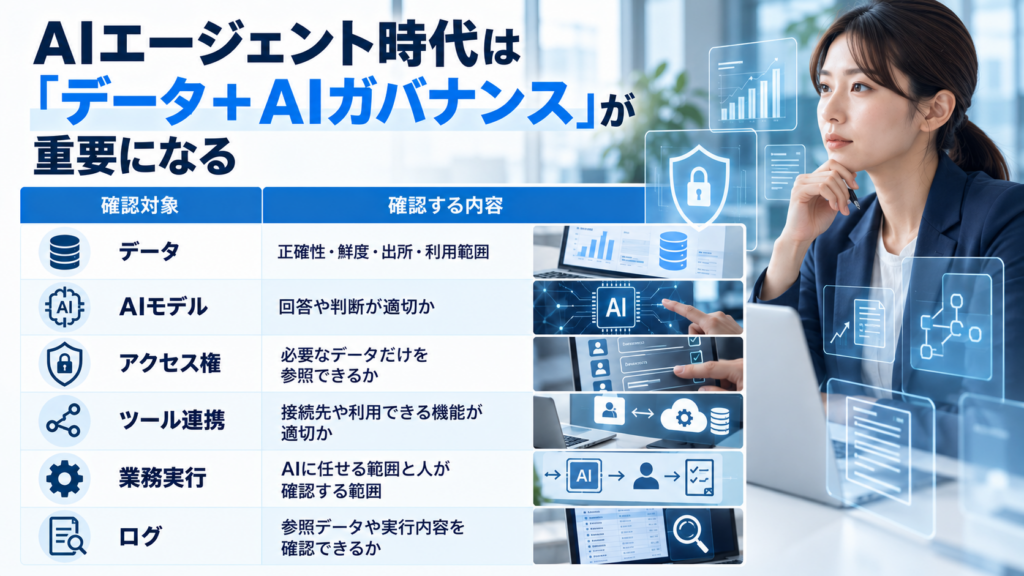
生成AIの活用が進むと、AIは質問に回答するだけでなく、社内データを検索し、その結果をもとに次の処理を行うようになります。AIエージェントでは、複数のシステムやツールと連携して業務を進めることも想定されます。
そのため、AIモデルの性能や出力だけを管理するのではなく、AIが利用するデータやアクセス権、実行できる処理まで含めて管理することが重要になります。
| 確認対象 |
確認する内容 |
| データ |
正確性・鮮度・出所・利用範囲 |
| AIモデル |
回答や判断が適切か |
| アクセス権 |
必要なデータだけを参照できるか |
| ツール連携 |
接続先や利用できる機能が適切か |
| 業務実行 |
AIに任せる範囲と人が確認する範囲 |
| ログ |
参照データや実行内容を確認できるか |
たとえば、AIが社内規程を検索して回答するだけであれば、問題が発生した際に人が回答内容を確認できます。しかし、AIが取得した情報をもとに別のシステムへ処理を依頼する場合、誤ったデータの影響が次の業務へ広がる可能性があります。
そのため、AIエージェントを利用する場合は、「何を回答したか」だけでなく、「どのデータを参照したか」「何を実行したか」「誰の権限で処理したか」を確認できる状態にすることが重要です。
金融AIの活用範囲が広がるほど、データ管理とAI管理を分けて考えることは難しくなります。データ品質、アクセス権、AIの出力、業務実行を一体で管理する「データ+AIガバナンス」の考え方が重要になります。
金融AI導入前に確認したいデータ品質チェックリスト
金融AIを導入する前には、AIモデルの選定だけでなく、利用するデータの状態や管理方法を確認することが重要です。以下の項目を整理しておくと、導入後に発生するデータ品質の問題を把握しやすくなります。
| 確認項目 |
チェック |
| AIを利用する目的が明確になっている |
□ |
| AIに必要なデータを特定している |
□ |
| データの管理責任者が明確になっている |
□ |
| 欠損や入力漏れを確認している |
□ |
| 重複データを確認している |
□ |
| システム間のデータ定義を確認している |
□ |
| データの更新頻度や最終更新日を把握している |
□ |
| 古い規程や不要なデータを整理している |
□ |
| AIが参照できるデータの範囲を設定している |
□ |
| データの出所や更新履歴を確認できる |
□ |
| PoCでデータ品質も評価する設計になっている |
□ |
| 本番導入後のデータ品質の監視方法が決まっている |
□ |
すべての項目を一度に完璧にする必要はありません。重要なのは、AIの利用目的に対して、どのデータ品質が不足しているのかを把握することです。
特に、正確性や鮮度だけでなく、データの管理責任者、アクセス権、更新履歴まで確認しておくことで、問題が発生した際に原因を追跡しやすくなります。
チェックリストをPoCや本番導入前の確認項目として活用し、AIとデータの両方を継続的に管理できる状態を整えることが重要です。
金融業務へのAI活用を検討しているものの、セキュリティや精度に不安はありませんか?
金融業界では、審査業務やリスク分析、問い合わせ対応、コンプライアンス対応など、AIを活用できる業務が増えています。一方で、セキュリティやガバナンス、法規制への対応も欠かせません。
当社では、金融業界の業務課題に合わせたAI導入戦略の立案から、ツール選定、
PoC、運用・定着まで一貫してサポートします。
「金融業務にAIをどう活用すべきか相談したい」という企業様は、お気軽にご相談ください。
金融AIについて相談する
よくある質問
Q1. 金融AIにおけるデータ品質とは何ですか?
金融AIが利用する顧客情報や取引情報、契約情報、社内規程などが、正確で必要な情報を含み、適切に更新・管理されている状態を指します。
Q2. なぜ金融AIではデータ品質が重要なのですか?
AIは利用するデータをもとに回答や分析を行うためです。元データに誤りや欠損、古い情報があれば、AIの回答や分析結果にも影響する可能性があります。
Q3. 高性能なAIモデルを使えばデータ品質の問題は解決できますか?
高性能なAIモデルを利用しても、元データの問題が自動的に解決されるとは限りません。AIモデルの性能とデータ品質は分けて考える必要があります。
Q4. 金融AIではどのようなデータが利用されますか?
顧客情報、取引情報、契約情報、与信情報、市場データ、社内規程や業務マニュアルなど、利用する業務に応じたさまざまなデータが対象になります。
Q5. 金融AIで起こりやすいデータ品質の問題には何がありますか?
データのサイロ化、定義の不統一、データの老朽化、欠損、重複、表記や入力ルールの不統一、アクセス権の不備などがあります。
Q6. データのサイロ化とは何ですか?
顧客情報や契約情報などが部門やシステムごとに分散している状態です。AIが必要な情報をまとめて参照できず、分析に必要な情報が不足する原因になります。
Q7. データ定義が統一されていないと何が起こりますか?
同じ項目でもシステムごとに意味や集計条件が異なると、AIによる集計や分析結果にズレが生じる可能性があります。
Q8. 古いデータが金融AIに与える影響は何ですか?
AIが現在の状況とは異なる情報を参照する可能性があります。顧客情報や契約情報、社内規程などでは、データの鮮度を確認することが重要です。
Q9. データの欠損はAIにどのような影響を与えますか?
必要な項目が入力されていない場合、AIが十分な情報を利用して分析できない可能性があります。特に顧客分析や融資・与信支援では、必要な情報が揃っているか確認することが重要です。
Q10. データの重複にはどのような問題がありますか?
同じ顧客や取引が複数登録されていると、集計や顧客分析にズレが生じる可能性があります。顧客IDや重複データを確認することが必要です。
Q11. 表記や入力ルールの不統一もデータ品質の問題ですか?
はい。略称や表記方法などが統一されていないと、AIによる検索漏れや分類ミスにつながる可能性があります。
Q12. アクセス権もデータ品質と関係しますか?
金融AIでは重要な管理項目の一つです。AIの参照範囲が適切に設定されていないと、本来参照すべきでない情報まで利用する可能性があります。
Q13. なぜAI導入によって既存のデータ問題が表面化するのですか?
従来は担当者が経験や業務知識によって、古い情報や例外的なデータを判断していた場合があります。AIでは、こうした暗黙のルールがデータや処理方法に反映されていなければ、そのまま利用する可能性があります。
Q14. 金融AIでは担当者の暗黙知をどのように扱うべきですか?
担当者が経験的に判断していたデータの意味や例外、更新方法などを整理し、データ定義や利用ルールとして明確にすることが重要です。
Q15. RAGではなぜデータの鮮度が重要なのですか?
RAGは検索した文書などをもとに回答を生成するためです。旧版の規程やマニュアルが検索対象に残っていると、AIが古い情報を根拠として回答する可能性があります。
Q16. 金融AIのデータ品質は何を基準に評価すればよいですか?
正確性、完全性、一貫性、鮮度、一意性、追跡可能性、アクセス適切性などの観点から評価します。AIの利用目的に応じて重視する項目を決めることが重要です。
Q17. データ品質はどのような指標で確認できますか?
エラー率、欠損率、不一致率、重複率、最終更新日や更新遅延などが確認指標の例です。また、データの出所や更新履歴、アクセス権も確認します。
Q18. すべてのデータに同じ品質基準が必要ですか?
必ずしも同じ基準にする必要はありません。社内規程では正確性や鮮度、顧客分析では欠損や重複など、AIの用途によって重視する品質項目は異なります。
Q19. AIの回答が間違っていたらモデルを変更すべきですか?
すぐにモデルを変更するのではなく、まず原因を確認することが重要です。古いデータ、欠損、検索精度、データ定義など、データ側に原因がある場合もあります。
Q20. AIの問題とデータの問題はどう切り分けますか?
AIがどのデータを取得したのかを確認します。取得したデータ自体が間違っていればデータ側、正しいデータを取得しているのに回答が不適切であれば、モデルやプロンプトなどAI側を確認します。
Q21. 金融AI導入前にすべての社内データを整備する必要がありますか?
最初からすべてのデータを整理する必要はありません。まずAIを利用する業務を決め、その業務で必要になるデータから優先的に整備します。
Q22. 金融AIのデータ整備はどのような順番で進めますか?
AIの利用目的を決め、必要なデータを棚卸しし、品質を確認します。その後、名寄せや重複排除、表記統一などを行い、導入後も継続的に品質を監視します。
Q23. データの棚卸しでは何を確認しますか?
AIに必要なデータがどこにあるのかに加えて、管理部署、更新頻度、機密区分などを整理します。
Q24. データ整備はAI導入前に一度行えば十分ですか?
一度だけでは十分ではありません。顧客情報や取引情報、社内規程などは継続的に変化するため、本番導入後も更新状況やデータ品質を確認する必要があります。
Q25. 金融AIのPoCでは何を評価すべきですか?
AI回答の正確性だけでなく、検索精度、欠損、重複、鮮度、データの一貫性、人による修正内容なども確認します。
Q26. PoCでデータ品質まで確認する理由は何ですか?
AIの回答に問題があったとき、モデル、検索、元データのどこに原因があるのかを把握するためです。本番導入前に改善すべきポイントを明確にできます。
Q27. 金融AIのデータガバナンスでは誰がデータを管理しますか?
AI開発部門だけでなく、業務部門、IT・データ管理部門、リスク管理・コンプライアンス部門、経営層などが役割を分担して管理することが重要です。
Q28. データの管理責任者を明確にする必要はありますか?
必要です。誰がデータを更新し、誤りが見つかった場合に誰が修正するのかを明確にすることで、AI導入後もデータ品質を管理しやすくなります。
Q29. AIエージェントではなぜデータ管理がさらに重要になるのですか?
AIエージェントは情報を回答するだけでなく、取得したデータをもとに別の処理やツール操作を行う場合があるためです。参照データに問題があると、その影響が後続の業務へ広がる可能性があります。
Q30. 金融AIを安定して活用するために最も重要なことは何ですか?
AIモデルだけを見るのではなく、AIが利用するデータまで一体で管理することです。利用目的、データ品質、アクセス権、管理責任、PoC、本番導入後の監視まで継続的に管理できる環境を整えることが重要です。
まとめ|金融AI成功の前提は信頼できるデータ環境を作ること
金融AIの導入では、高性能なAIモデルを選ぶことだけでなく、AIが利用するデータの品質を整えることが重要です。
顧客情報や取引情報、契約情報、社内規程などに欠損・重複・古い情報・定義の不一致があれば、AIの回答や分析にも影響する可能性があります。
金融AIを導入する際は、次の流れでデータ環境を整えることが基本です。
- AIを利用する目的を決める
- 必要なデータを特定する
- データ品質を確認する
- 欠損・重複・表記などを整備する
- アクセス権や管理責任を明確にする
- PoCでAIとデータの両方を評価する
- 本番導入後も継続的に監視する
特に重要なのは、AIの結果に問題があったときに、「AIモデルの問題」と「データの問題」を分けて確認できる状態を作ることです。
また、RAGやAIエージェントの活用が広がれば、AIがどのデータを参照し、どの権限で、どの処理を行ったのかまで管理する必要があります。
金融AIを安定して活用するためには、「どのAIを導入するか」だけではなく、「AIが信頼できるデータを利用できる環境をどう作るか」という視点が欠かせません。AIとデータを一体で管理することが、継続的な金融AI活用の基盤となります。
SUPERVISED BY
平出 大輔
株式会社Start Challenge Consulting
代表取締役CEO/AI・DXコンサルタント
約10年間、外資系コンサルティングファームにて企業のDX推進・業務改革・AI活用支援など数多くのプロジェクトを担当。これまで培った知見をもとに株式会社Start Challenge Consultingを創業し、生成AI、データ活用、DX推進を軸とした経営・業務改革支援を行っています。
「仕事=生きがい・楽しさ」という価値観を大切にし、クライアントと同じ目線で未来を創る真のパートナーとして、日本を代表するコンサルティングファームを目指しています。