Snowflake AIは、自然言語による質問からSQLを生成できるため、データ分析の効率化につながる技術として注目されています。従来はSQLの専門知識が必要だった集計やデータ抽出も、AIを活用することで、より簡単に取り組めるようになります。
しかし、AIが生成したSQLが必ず正しく動作するとは限りません。存在しないカラムの参照、データ型の不一致、JOIN条件の誤りなど、実務ではさまざまな問題が発生する可能性があります。
さらに注意したいのは、SQLが正常に実行されても、集計条件やデータの解釈によって誤った分析結果が算出されることです。エラーが表示されない場合、問題に気づかないまま数値を業務判断に利用してしまうおそれがあります。
本記事では、Snowflake AIによるSQL生成の仕組みを整理し、実務で起こり得る7つのエラーと誤集計の原因を具体的に検証します。さらに、エラーの確認方法や修正手順、SQL生成の精度を高める改善策を解説し、Snowflake AIとSQLを実務で安全かつ効果的に活用するためのポイントを紹介します。
Snowflake AIとSQLはなぜ相性が良いといわれるのか
Snowflake AIとSQLの相性が良い理由は、自然言語による質問からSQLを生成し、Snowflake上のデータ分析につなげられることです。SQLを一から記述する負担が減り、売上集計や顧客分析などを効率化できます。
特に、Cortex AnalystやCortex Agentsを活用することで、業務上の質問に対応するSQLの生成を支援できます。
Snowflake AIがSQL生成に適している理由
| 特徴 |
主なメリット |
| 自然言語によるSQL生成 |
SQL作成の手間を削減できる |
| Snowflakeとの連携 |
保存されたデータを分析に活用できる |
| Semantic Viewsの活用 |
指標やデータの関係をAIに伝えられる |
| 複数テーブルの分析 |
定義済みの関係に基づく集計を支援できる |
| 定型分析の効率化 |
繰り返し行う集計を簡単にできる |
SQL生成AIが効果を発揮する業務
Snowflake AIは、売上集計、顧客別の購入分析、期間別の比較、KPIの確認など、集計条件が明確な業務で活用できます。特に、必要なテーブルや指標が整理されている環境では、SQL生成の効率化が期待できます。
ただし、SQLを生成できることと、正しい分析結果を得られることは同じではありません。カラムの参照ミスやJOIN条件の誤り、業務指標の解釈違いによって、実行エラーや誤集計が発生する可能性があります。
そのため、Snowflake AIの効果を十分に引き出すには、SQL生成機能だけでなく、データ設計や結果の検証も重要です。
Snowflake AIのSQLエラーを検証する環境と評価方法
Snowflake AIによるSQL生成の正確性を評価するには、SQLが実行できるかだけでなく、取得したデータが質問の意図と一致しているかを確認する必要があります。そのため、検証条件を統一し、生成SQLと正しい集計結果を比較することが重要です。
検証対象となるSnowflakeの機能
SQL生成の検証では、Cortex AnalystやCortex Agentsを対象とします。これらの機能は、自然言語による質問からSQLを生成し、Snowflake上のデータ分析を支援します。
また、Semantic Viewsで定義されたテーブルの関係や業務指標が、SQL生成にどのような影響を与えるかも確認します。
検証に使用するデータ構造
検証には、顧客情報、注文履歴、商品情報など、複数テーブルを組み合わせたデータを想定します。
具体的には、顧客ID、注文日、商品ID、購入金額などの項目を用意し、売上集計や顧客別分析を行います。
特に、複数テーブルのJOIN、日付による抽出、金額の集計などは、SQLの誤りを確認するうえで重要な検証対象です。
AIへの質問と期待する結果
AIには「先月の商品別売上を集計して」「顧客ごとの購入金額を表示して」など、実務で利用する自然言語の質問を与えます。
その際、事前に検証済みのSQLと期待される集計結果を用意し、AIが生成したSQLと比較します。質問の条件が曖昧な場合は、期間や集計対象を明確にしたうえで再検証します。
SQLの正確性を評価する4つの基準
SQLの品質は、次の4つの観点から評価します。
SQL生成:質問の意図に合ったSQLが作成されているかを確認します。
実行可否:構文エラーや権限エラーが発生しないかを確認します。
結果の正確性:検証済みSQLと集計結果が一致するかを確認します。
実行性能:処理時間やデータ読み込み量に問題がないかを確認します。
さらに、実行したSQL、エラーメッセージ、修正内容、再実行結果を記録することで、問題の原因を追跡しやすくなります。
このように検証条件を整理することで、AIのSQL生成能力だけでなく、実務で利用する際の正確性や課題を具体的に評価できます。
Snowflake AIで実務上問題となる7つのSQLエラーを検証
Snowflake AIは自然言語からSQLを生成できますが、生成されたSQLが必ず正しく動作するとは限りません。カラムの参照ミス、データ型の不一致、集計条件の誤りなど、さまざまな問題が発生する可能性があります。
ここでは、実務で起こり得る7つの代表的な問題と、その原因・改善方法を解説します。なお、以下は発生条件を説明するための想定事例であり、実測結果ではありません。
Snowflake AIで注意したい7つのSQLエラーと問題
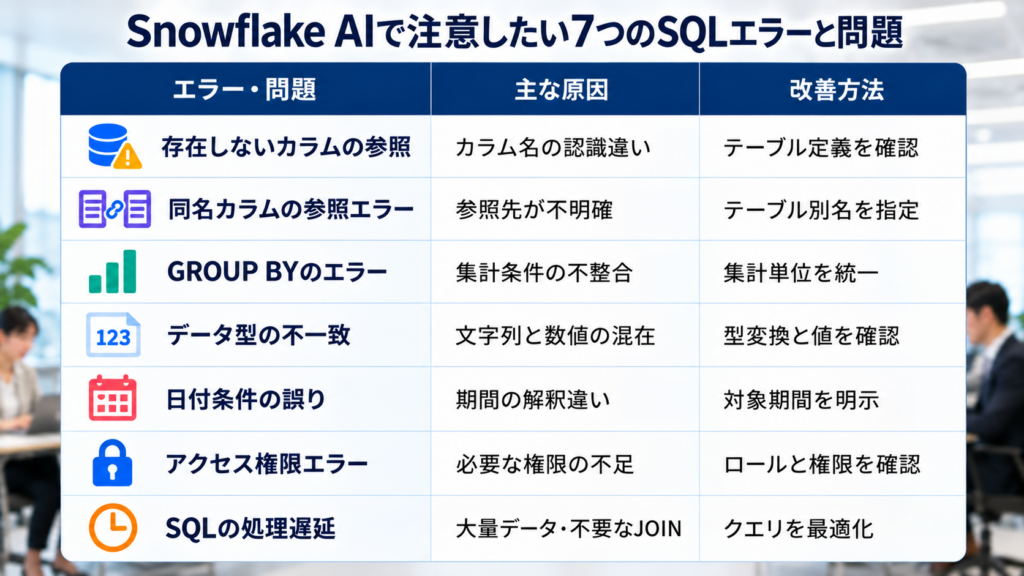
| エラー・問題 |
主な原因 |
改善方法 |
| ① 存在しないカラムの参照 |
カラム名の認識違い |
テーブル定義を確認 |
| ② 同名カラムの参照エラー |
参照先が不明確 |
テーブル別名を指定 |
| ③ GROUP BYのエラー |
集計条件の不整合 |
集計単位を統一 |
| ④ データ型の不一致 |
文字列と数値の混在 |
型変換と値の確認 |
| ⑤ 日付条件の誤り |
期間の解釈違い |
対象期間を明示 |
| ⑥ アクセス権限エラー |
必要な権限の不足 |
ロールと権限を確認 |
| ⑦ SQLの処理遅延 |
大量データや不要なJOIN |
クエリを最適化 |
存在しないカラムを参照するエラー
AIが生成したSQLに存在しないカラム名が含まれると、「invalid identifier」などのエラーが発生する場合があります。
例えば、実際のカラム名が「ORDER_AMOUNT」であるにもかかわらず、「SALES_AMOUNT」を参照すると、SQLを実行できない可能性があります。
修正するには、テーブル定義と生成SQLを照合し、正しいカラム名を指定します。また、Semantic Viewsにカラムの意味を適切に定義することも重要です。
複数テーブルの同名カラムによるエラー
複数のテーブルに同じ名前のカラムが存在すると、参照先を特定できず「ambiguous column name」というエラーが発生する場合があります。
例えば、顧客テーブルと注文テーブルの両方に「CUSTOMER_ID」が存在するケースです。
この問題は、テーブル別名を使って参照先を明示することで解決できます。また、JOIN条件が正しいかも確認する必要があります。
GROUP BYや集計関数のエラー
売上や顧客数を集計する際、SELECT句とGROUP BY句の指定が一致していないと、SQLのコンパイルエラーが発生することがあります。
例えば、商品別売上を求める場合は、商品単位で集計する必要があります。
修正するには、分析目的に合わせてGROUP BYの条件を整理し、SUMやCOUNTなどの集計関数を適切に使用します。
データ型の不一致によるエラー
文字列として保存された金額を数値として計算する場合、変換できない値が含まれているとエラーが発生する可能性があります。
例えば、数値データに通貨記号や文字が混在しているケースです。
改善には、データ型の確認と適切な変換処理が必要です。TRY_CASTやTRY_TO_NUMBERなどを利用できますが、変換できずNULLになったデータの扱いにも注意が必要です。
日付条件の解釈による問題
「先月の売上」と質問した場合、AIが直近30日間を対象とするSQLを生成すると、期待する集計結果と異なる可能性があります。
また、DATEとTIMESTAMPの違いやタイムゾーンによって、対象データが変わる場合もあります。
修正するには、集計開始日と終了日を明確に指定し、生成SQLの期間条件を確認することが重要です。
アクセス権限不足によるエラー
SQLの構文が正しくても、実行ユーザーに必要な権限がなければデータを取得できません。
Snowflakeではロールによってアクセスが管理されており、対象テーブルやスキーマへの権限不足が原因となる場合があります。
この場合は、実行ロールと必要な権限を確認し、管理者が適切なアクセス設定を行います。
SQLの処理時間が長くなる問題
生成されたSQLが正常に実行できても、不要な大量データの読み込みや複雑なJOINによって処理時間が長くなることがあります。
例えば、特定期間の売上分析であるにもかかわらず、全期間のデータを読み込むケースです。
改善するには、抽出条件を限定し、必要なカラムのみを取得します。また、Query HistoryやQuery Profileで処理時間や負荷を確認することも有効です。
7つの問題から分かる共通点
これらの問題は、AIのSQL生成能力だけでなく、データ構造、集計条件、権限設定などにも関係しています。
そのため、生成SQLに問題が発生した場合は、SQLそのものと実行環境の両方を確認することが重要です。
さらに注意したいのは、エラーが表示されなくても、SQLが誤った分析結果を返す可能性があることです。次に、SQLが正常に実行されても集計結果が間違うケースを確認します。
データは蓄積されているのに、経営判断や業務改善に活かせていないと感じていませんか?
AIやBIツールを導入するだけでは、十分な成果につながらないケースも少なくありません。
当社では、データ分析の目的整理から分析基盤の構築、ダッシュボード作成、AIを活用した業務改善まで一貫してご支援します。
「何から始めればよいかわからない」という段階でも、お気軽にご相談ください。
データ分析について相談する
SQLが正常に実行されても分析結果が間違う3つのケース
Snowflake AIが生成したSQLは、エラーなく実行できても、必ずしも正しい分析結果を返すとは限りません。
特に、JOINによる重複集計、KPIの定義違い、NULLや欠損データの扱いは、SQLの構文に問題がなくても誤集計につながる可能性があります。
| 問題 |
主な原因 |
改善方法 |
| ① JOINによる重複集計 |
1対多の結合でデータが重複 |
JOIN条件と集計単位を確認 |
| ② KPIの定義違い |
売上や顧客数の計算基準が不明確 |
指標定義と計算ルールを統一 |
| ③ NULL・欠損データの影響 |
集計関数によるNULLの扱いの違い |
欠損値の意味と処理方法を確認 |
JOINによる重複集計では、注文テーブルと注文明細テーブルを結合した際、同じ注文金額が複数回計算されることがあります。防ぐには、JOIN前後の件数を確認し、適切な単位で集計する必要があります。
KPIの定義違いでは、売上に返品やキャンセルを含めるか、顧客数を注文回数ではなく実人数で数えるかによって結果が変わります。Semantic Viewsなどで計算基準を統一することが重要です。
NULLや欠損データの影響では、COUNT(*)とCOUNT(カラム名)で件数が異なったり、AVGがNULLを除外して平均を算出したりします。NULLを0に置き換える前に、データの意味を確認する必要があります。
このように、SQLの実行成功と分析結果の正確性は別の問題です。Snowflake AIを実務で活用する際は、集計条件やデータの意味を確認し、検証済みSQLと結果を比較することが重要です。
Snowflake AIが生成したSQLのエラーを調査・原因特定する方法
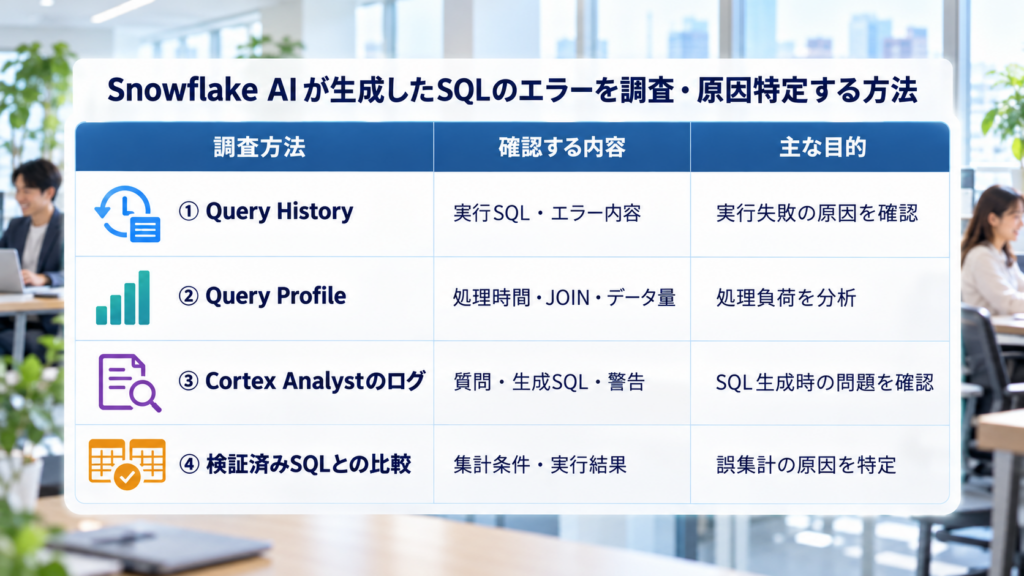
Snowflake AIが生成したSQLに問題が発生した場合は、エラーメッセージだけでなく、生成されたSQLや実行履歴を確認することが重要です。
Snowflakeには、SQLの実行状況や処理内容を調査する機能が用意されており、原因の特定や改善に活用できます。
| 調査方法 |
確認する内容 |
主な目的 |
| ① Query History |
実行SQL・エラー内容 |
実行失敗の原因を確認 |
| ② Query Profile |
処理時間・JOIN・データ量 |
処理負荷を分析 |
| ③ Cortex Analystのログ |
質問・生成SQL・警告 |
SQL生成時の問題を確認 |
| ④ 検証済みSQLとの比較 |
集計条件・実行結果 |
誤集計の原因を特定 |
Query Historyでは、実行されたSQL、エラーコード、エラーメッセージ、実行時間などを確認できます。QUERY_IDを記録しておくことで、問題が発生したSQLを特定しやすくなります。
Query Profileでは、SQLの処理内容を詳しく確認できます。大量データの読み込みやJOINによる負荷などを分析し、処理時間が長くなる原因を調査します。
Cortex Analystのログでは、AIに入力された質問、生成されたSQL、警告やエラーなどを確認できます。質問の解釈やSQL生成時に問題がなかったかを調べる際に役立ちます。
検証済みSQLとの比較では、生成SQLと正しいSQLのJOIN条件、WHERE句、GROUP BY句などを照合します。さらに集計結果を比較することで、構文エラーだけでなく、正常に実行されたSQLの誤集計も発見しやすくなります。
調査後は、発生した問題、原因、修正内容、再実行結果を記録することが重要です。同じ問題が再発した場合にも、過去の検証内容を参考にできます。
このように、SQLの生成過程と実行結果を分けて確認することで、問題がAIのSQL生成、データ構造、実行環境のどこにあるのかを判断しやすくなります。
Snowflake AIのSQL生成でエラーが発生する根本原因
Snowflake AIによるSQL生成で問題が発生する原因は、AIの生成能力だけではありません。データ構造や業務指標の定義、質問内容、データ品質など、複数の要因が関係しています。
特に、AIが参照する情報が不十分な場合、SQLの構文が正しくても、意図した分析結果を得られない可能性があります。
| 根本原因 |
主な問題 |
改善の方向性 |
| ① テーブル・カラム定義の不足 |
データの意味を誤って解釈 |
定義や説明を明確化 |
| ② テーブル間の関係が不明確 |
JOIN条件の誤り |
結合関係を整理 |
| ③ KPI定義の不統一 |
集計結果が一致しない |
計算ルールを統一 |
| ④ 自然言語の質問が曖昧 |
抽出条件や集計単位を誤解 |
質問条件を具体化 |
| ⑤ データ品質の問題 |
欠損・重複・型の不一致 |
データ品質を改善 |
テーブルやカラムの定義が不足している場合、AIがデータの意味を正確に判断できず、不適切なカラムを参照する可能性があります。Semantic Viewsなどで業務上の意味を明確にすることが重要です。
テーブル間の関係が不明確な場合、誤ったJOINによってデータが重複したり、必要なレコードが除外されたりすることがあります。テーブルの結合条件と集計単位を整理する必要があります。
KPIの定義が統一されていない場合、売上や顧客数などの計算方法が異なり、期待する分析結果と一致しない可能性があります。指標の計算基準を明確にすることが重要です。
質問内容が曖昧な場合、AIが期間や対象データを異なる条件で解釈することがあります。集計期間、対象、指標を具体的に指定することで、解釈違いを減らせます。
データ品質に問題がある場合、SQLが正しくても誤った結果につながります。欠損値、重複データ、データ型の不一致などを継続的に確認する必要があります。
このように、SQL生成の正確性を高めるには、AIへの指示だけでなく、データ構造や業務ルールを整備することが重要です。問題の原因を明確にすることで、適切な改善策を選択しやすくなります。
データは蓄積されているのに、経営判断や業務改善に活かせていないと感じていませんか?
AIやBIツールを導入するだけでは、十分な成果につながらないケースも少なくありません。
当社では、データ分析の目的整理から分析基盤の構築、ダッシュボード作成、AIを活用した業務改善まで一貫してご支援します。
「何から始めればよいかわからない」という段階でも、お気軽にご相談ください。
データ分析について相談する
Snowflake AIのSQL生成精度を高める7つの改善策
Snowflake AIによるSQL生成の精度を高めるには、AIへの質問方法だけでなく、データ構造や業務指標の定義を整備することが重要です。
特に、Semantic Viewsの活用、検証済みSQLの登録、継続的な評価を組み合わせることで、SQL生成時の誤りを減らし、分析結果の信頼性を高めることが期待できます。
| 改善策 |
主な取り組み |
目的 |
| ① カラム定義の明確化 |
テーブル・カラムの意味を整理 |
参照ミスを減らす |
| ② Semantic Viewsの整備 |
データの関係や指標を定義 |
AIの解釈を支援する |
| ③ KPI定義の統一 |
計算方法・集計基準を明確化 |
集計結果の不一致を防ぐ |
| ④ JOIN条件の整理 |
テーブル間の関係を確認 |
重複集計を防ぐ |
| ⑤ 検証済みSQLの登録 |
Verified Query Repositoryを活用 |
正しいSQL生成を支援する |
| ⑥ 質問条件の明確化 |
期間・対象・指標を指定 |
解釈違いを減らす |
| ⑦ 継続的な評価 |
生成SQLと正解SQLを比較 |
精度低下を早期発見する |
カラム定義の明確化では、テーブル名やカラム名だけでなく、データの意味や用途を整理します。これにより、AIが不適切なカラムを選択するリスクを減らせます。
Semantic Viewsの整備では、テーブル間の関係や業務指標を定義します。AIがデータ構造と業務上の意味を理解するための情報を提供できます。
KPI定義の統一では、売上や顧客数などの計算基準を明確にします。部署や担当者によって異なる集計ルールを整理することが重要です。
JOIN条件の整理では、テーブル間の結合キーやデータの集計単位を確認します。意図しないレコードの重複や欠落を防ぐために必要です。
検証済みSQLの登録では、Verified Query Repositoryを活用し、質問と正しいSQLの組み合わせを管理します。Cortex Analystが類似する質問に対応する際の参考情報として利用できます。
質問条件の明確化では、集計期間、対象データ、必要な指標を具体的に指定します。曖昧な質問によるSQL生成の解釈違いを減らすことが期待できます。
継続的な評価では、生成SQLの実行結果を検証済みSQLと比較し、正確性を確認します。データ構造や業務ルールが変更された場合も、再評価することが重要です。
これらの改善策を組み合わせることで、SQL生成の正確性を高めるための基盤を整えられます。ただし、重要な業務データを扱う場合は、AIによる生成結果をそのまま採用せず、人による確認を組み込む必要があります。
Snowflake AIのSQL生成の改善効果をどのように評価すべきか
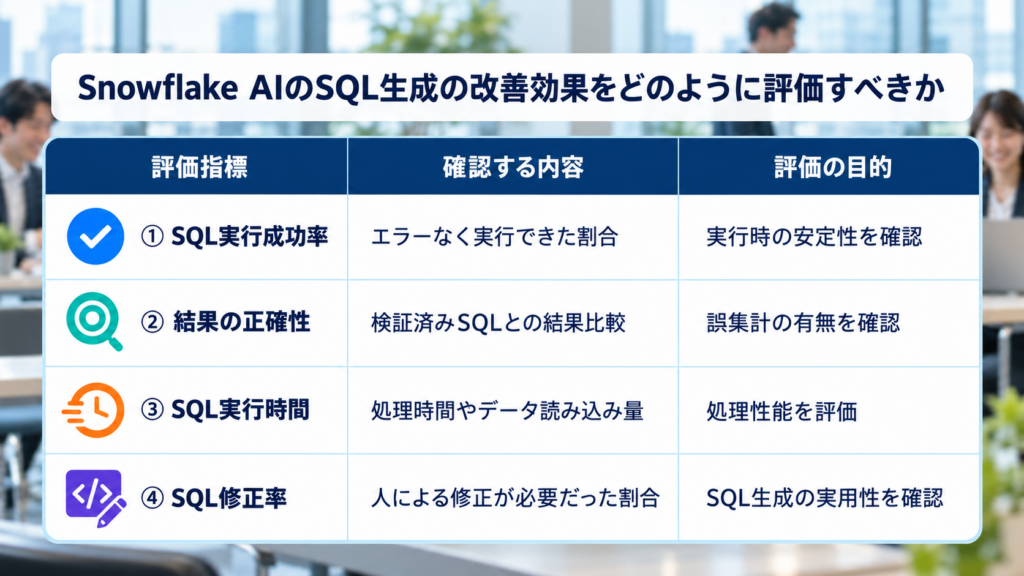
Snowflake AIのSQL生成を改善した後は、実際に正確性や処理性能が向上したかを確認する必要があります。SQLが実行できるようになっただけでは、改善が成功したとは判断できません。
特に重要なのは、生成SQLの実行成功率、分析結果の正確性、処理時間、修正が必要なSQLの割合を継続的に評価することです。
| 評価指標 |
確認する内容 |
評価の目的 |
| ① SQL実行成功率 |
エラーなく実行できた割合 |
実行時の安定性を確認 |
| ② 結果の正確性 |
検証済みSQLとの結果比較 |
誤集計の有無を確認 |
| ③ SQL実行時間 |
処理時間やデータ読み込み量 |
処理性能を評価 |
| ④ SQL修正率 |
人による修正が必要だった割合 |
SQL生成の実用性を確認 |
SQL実行成功率では、生成されたSQLのうち、エラーなく実行できた割合を確認します。ただし、実行に成功しても集計結果が正しいとは限らないため、単独で評価しないことが重要です。
結果の正確性では、生成SQLと検証済みSQLを同じデータ条件で実行し、件数や金額などを比較します。SQLの記述方法が異なっていても、正しい結果が得られているかを確認します。
SQL実行時間では、Query HistoryやQuery Profileを利用して処理性能を確認します。比較する際は、データ量やウェアハウスの設定など、実行条件の違いにも注意が必要です。
SQL修正率では、生成後にカラム名、JOIN条件、集計方法などの修正が必要だった割合を記録します。修正内容を分類することで、改善すべき問題を把握しやすくなります。
また、AIによるSQL生成は同じ質問でも結果が変わる可能性があるため、複数回の検証も有効です。SnowflakeのCortex Analyst Evaluationsなどを活用すれば、検証済みクエリを基準にSQLの正確性を継続的に評価できます。
改善前後の結果を比較する際は、同じ質問、データ、評価基準を使用し、測定条件と実測値を記録することが重要です。継続的な評価によって、SQL生成の精度低下や新たな問題を発見しやすくなります。
Snowflake AIにSQLを任せられる業務と任せられない業務
Snowflake AIはSQL作成の効率化に役立ちますが、すべての分析業務をAIだけで完結できるわけではありません。業務の複雑さや分析結果の重要性に応じて、AIと人の役割を分ける必要があります。
| 業務の種類 |
具体例 |
活用方針 |
| 定型的な集計業務 |
売上集計・データ抽出 |
AIによるSQL生成を活用 |
| 標準化されたKPI分析 |
顧客数・購入金額の集計 |
定義済み指標に基づいて活用 |
| 複雑なデータ分析 |
複数テーブルの結合・例外処理 |
人によるSQLと結果の検証が必要 |
| 重要な意思決定に使う分析 |
財務分析・経営指標の算出 |
検証済みSQLとの照合を徹底 |
売上集計や定型レポートなど、データ構造と計算ルールが明確な業務では、AIによるSQL生成を活用しやすくなります。一方、複雑なJOINや業務固有の例外処理を伴う分析では、生成SQLの確認が重要です。
特に、財務分析や経営判断に利用する数値は、SQLが正常に実行されただけで正しいと判断せず、計算条件や集計結果を検証する必要があります。
Snowflake AIにはSQL作成を支援させ、人が業務上の正確性を確認することで、効率性と信頼性の両立を目指せます。
データは蓄積されているのに、経営判断や業務改善に活かせていないと感じていませんか?
AIやBIツールを導入するだけでは、十分な成果につながらないケースも少なくありません。
当社では、データ分析の目的整理から分析基盤の構築、ダッシュボード作成、AIを活用した業務改善まで一貫してご支援します。
「何から始めればよいかわからない」という段階でも、お気軽にご相談ください。
データ分析について相談する
Snowflake AIとSQLに関するよくある質問(FAQ)
Q1. Snowflake AIでは自然言語からSQLを生成できますか?
はい。Cortex AnalystやCortex Agentsなどを活用することで、自然言語による質問からSQLを生成できます。売上集計や顧客分析など、データ分析に必要なSQLの作成を支援します。
Q2. Cortex Analystとはどのような機能ですか?
Cortex Analystは、自然言語による質問をSQLに変換するSnowflakeの機能です。Semantic Viewsなどに定義されたデータ構造や業務指標を利用し、質問に対応したSQLの生成を支援します。
Q3. Cortex AgentsとCortex Analystにはどのような関係がありますか?
Cortex Agentsは、Cortex Analystの機能を利用して構造化データへの質問に対応できます。Cortex AnalystがSQL生成を担い、Cortex Agentsは複数の機能を組み合わせた分析処理を支援します。
Q4. Snowflake AIのSQL生成にSemantic Viewsが重要なのはなぜですか?
Semantic Viewsは、テーブル間の関係や業務指標、データの意味を定義する仕組みです。AIがデータ構造を理解するための情報を提供し、SQL生成時の解釈違いを減らすことに役立ちます。
Q5. SQLの専門知識がなくてもSnowflake AIを利用できますか?
自然言語で質問できるため、SQLを一から記述する負担を減らせます。ただし、生成されたSQLや分析結果の正確性を判断するには、データの意味や集計条件を理解していることが重要です。
Q6. Snowflake AIによるSQL生成はどのような業務に適していますか?
売上集計、顧客別の購入分析、データ抽出、定型レポートの作成などに適しています。特に、データ構造と計算ルールが明確な業務では、SQL作成の効率化が期待できます。
Q7. Snowflake AIが生成したSQLは必ず実行できますか?
いいえ。存在しないカラムの参照、構文の不整合、データ型の問題、アクセス権限の不足などによって、SQLが実行できない場合があります。生成後の確認が必要です。
Q8. invalid identifierエラーはなぜ発生するのですか?
SQLが参照するカラム名などを正しく識別できない場合に発生します。存在しないカラム名や誤った識別子を使用していないか、実際のテーブル定義と照合することが重要です。
Q9. ambiguous column nameエラーとは何ですか?
複数のテーブルに同名のカラムが存在し、参照先を特定できない場合などに発生するエラーです。テーブル別名を利用して対象カラムを明示することで対処できます。
Q10. GROUP BYの指定を間違えるとどうなりますか?
SELECT句との整合性が取れていない場合、SQLのコンパイルエラーが発生することがあります。また、集計単位を誤ると結果が変わるため、分析目的に合わせてGROUP BYを指定する必要があります。
Q11. データ型の不一致によるSQLエラーはどのように発生しますか?
文字列として保存された値を数値として処理する際、変換できない文字が含まれているとエラーになる場合があります。カラムのデータ型と実際の値を確認することが重要です。
Q12. TRY_CASTやTRY_TO_NUMBERはどのような場合に使いますか?
データ型の変換時にエラーが発生する可能性がある場合に利用できます。対応する変換に失敗した際はNULLを返せますが、変換できなかったデータをどのように扱うかも確認する必要があります。
Q13. 「先月の売上」という質問で集計結果が間違うことはありますか?
あります。「先月」を前月の暦月ではなく直近30日間として処理すると、異なる結果になります。集計開始日と終了日を明確に指定し、生成SQLの条件を確認することが重要です。
Q14. DATEとTIMESTAMPの違いはSQL分析に影響しますか?
はい。DATEは日付を扱い、TIMESTAMPは日付と時刻を扱います。時刻やタイムゾーンの設定によって抽出対象が変わる場合があるため、期間条件を適切に設定する必要があります。
Q15. SQLの構文が正しいのにアクセス権限エラーが出るのはなぜですか?
実行ユーザーのロールに、対象データベースやスキーマ、テーブルへの必要な権限がない可能性があります。SQLの修正だけでは解決できないため、実行ロールと権限設定を確認します。
Q16. AIが生成したSQLの処理時間が長くなる原因は何ですか?
大量データの読み込み、不要なJOIN、抽出条件の不足などが原因になることがあります。データ量やウェアハウスの設定も影響するため、Query Profileなどで処理内容を確認します。
Q17. Query Historyでは何を確認できますか?
実行されたSQL、エラーコード、エラーメッセージ、実行時間などを確認できます。QUERY_IDを利用することで、問題が発生したSQLを特定し、原因を調査しやすくなります。
Q18. Query Profileはどのような分析に役立ちますか?
SQLの実行処理を詳しく確認する際に役立ちます。データの読み込みやJOINなどの処理を調べ、実行時間が長くなる原因や改善すべき箇所を把握できます。
Q19. Cortex Analystのログではどのような情報を確認できますか?
AIに入力された質問、生成されたSQL、警告やエラーなどを確認できます。必要な権限を持つユーザーがログを調査することで、SQL生成時の問題を分析できます。
Q20. SQLが正常に実行されれば分析結果も正しいと判断できますか?
いいえ。SQLが正常終了しても、JOIN条件や集計単位、指標定義が誤っていれば、不正確な結果になる可能性があります。実行成功と分析結果の正確性は分けて評価する必要があります。
Q21. JOINによって売上が二重計上されるのはなぜですか?
1対多の関係にあるテーブルを結合すると、注文情報などが複数行に展開される場合があります。その状態で注文単位の金額を合計すると重複計上につながるため、結合条件と集計単位の確認が必要です。
Q22. KPIの定義が異なるとSQLの集計結果は変わりますか?
変わります。例えば、売上に返品やキャンセルを含めるかによって集計金額が異なります。業務上の計算基準を明確にし、Semantic Viewsなどで統一することが重要です。
Q23. COUNT(*)とCOUNT(カラム名)にはどのような違いがありますか?
COUNT(*)は対象となる行を数えます。一方、COUNT(カラム名)は指定したカラムがNULLである行を除いて数えます。欠損値がある場合、結果が異なることがあります。
Q24. NULLを含むデータでAVGを使用するとどうなりますか?
AVGはNULLを除外して平均値を計算します。そのため、NULLを0として扱う場合とは結果が異なります。欠損値が何を意味するのかを確認し、適切な計算方法を選ぶ必要があります。
Q25. AIが生成したSQLの正確性はどのように確認しますか?
事前に用意した検証済みSQLと同じ条件で実行し、件数や金額などの結果を比較します。差異がある場合は、JOIN条件、WHERE句、GROUP BY句などを確認して原因を調べます。
Q26. Verified Query Repositoryとは何ですか?
自然言語の質問と、それに対応する検証済みSQLを管理する仕組みです。Cortex Analystが関連する質問に対してSQLを生成する際の参考情報として活用でき、正確性の向上に役立ちます。
Q27. AIへの質問方法を変えることでSQL生成の精度は改善できますか?
改善が期待できます。例えば、集計期間、対象となるデータ、必要な指標を具体的に指定することで、質問の解釈違いを減らせます。ただし、データ定義自体に問題がある場合は、その整備も必要です。
Q28. SQL生成の改善効果はどのような指標で評価できますか?
SQL実行成功率、分析結果の正確性、実行時間、人による修正が必要だった割合などを使用できます。改善前後で同じ条件を使い、複数の指標を組み合わせて評価することが重要です。
Q29. SQL生成の正確性は一度検証すれば十分ですか?
いいえ。生成AIは同じ質問でも異なるSQLを生成する可能性があります。また、データ構造や業務ルールが変更される場合もあるため、複数回の検証と継続的な評価が重要です。
Q30. Snowflake AIにSQL作成をすべて任せても問題ありませんか?
すべてを無条件に任せることは推奨できません。定型的なデータ抽出や集計ではAIを活用し、複雑な分析や重要な経営指標については人がSQLと結果を確認することが重要です。AIと人の役割を適切に分けることで、効率性と信頼性の両立を目指せます。
まとめ|Snowflake AIとSQLの相性は良いが、実務では検証体制が欠かせない
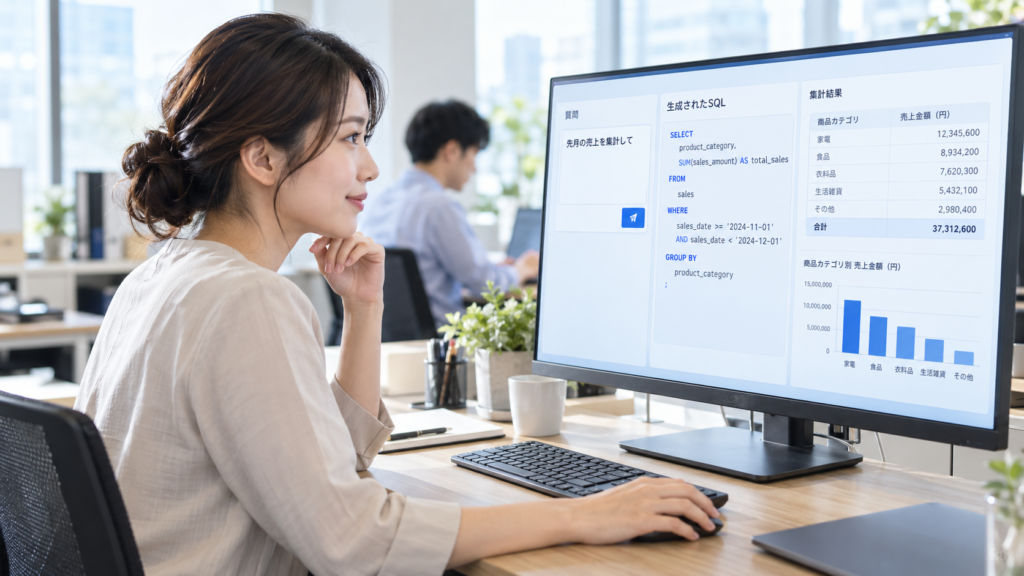
Snowflake AIは、自然言語からSQLを生成できるため、データ抽出や集計業務の効率化に役立ちます。一方で、生成されたSQLが必ず正しく動作し、期待どおりの分析結果を返すとは限りません。
実務では、カラムの参照ミス、データ型の不一致、JOIN条件の誤り、アクセス権限の不足など、さまざまな問題が発生する可能性があります。特に注意すべきなのは、SQLが正常に実行されても、集計条件や指標定義によって誤った結果が算出されることです。
こうした問題を防ぐには、Semantic Viewsによるデータ定義の整備、検証済みSQLの活用、Query Historyなどを利用した継続的な確認が重要です。また、分析結果を重要な業務判断に使用する場合は、人による検証も欠かせません。
Snowflake AIとSQLの相性は良いと考えられますが、実務で信頼できる分析を実現するには、AIの生成能力だけでなく、企業側のデータ設計と検証体制が重要になります。AIと人の役割を適切に分けることが、効果的な活用につながります。
SUPERVISED BY
平出 大輔
株式会社Start Challenge Consulting
代表取締役CEO/AI・DXコンサルタント
約10年間、外資系コンサルティングファームにて企業のDX推進・業務改革・AI活用支援など数多くのプロジェクトを担当。これまで培った知見をもとに株式会社Start Challenge Consultingを創業し、生成AI、データ活用、DX推進を軸とした経営・業務改革支援を行っています。
「仕事=生きがい・楽しさ」という価値観を大切にし、クライアントと同じ目線で未来を創る真のパートナーとして、日本を代表するコンサルティングファームを目指しています。