企業では、契約書や請求書などのPDFをAIで読み取る機会が増えています。しかし、同じ内容でもスキャンPDFとテキストPDFでは、文字や数値、表の読み取り精度に違いが生じることがあります。
本記事では、PDF形式によるAIの読み取り精度の違いや、誤認識が発生する原因、精度の検証方法と改善策を分かりやすく解説します。
スキャンPDFとテキストPDFではどちらが正確なのか?
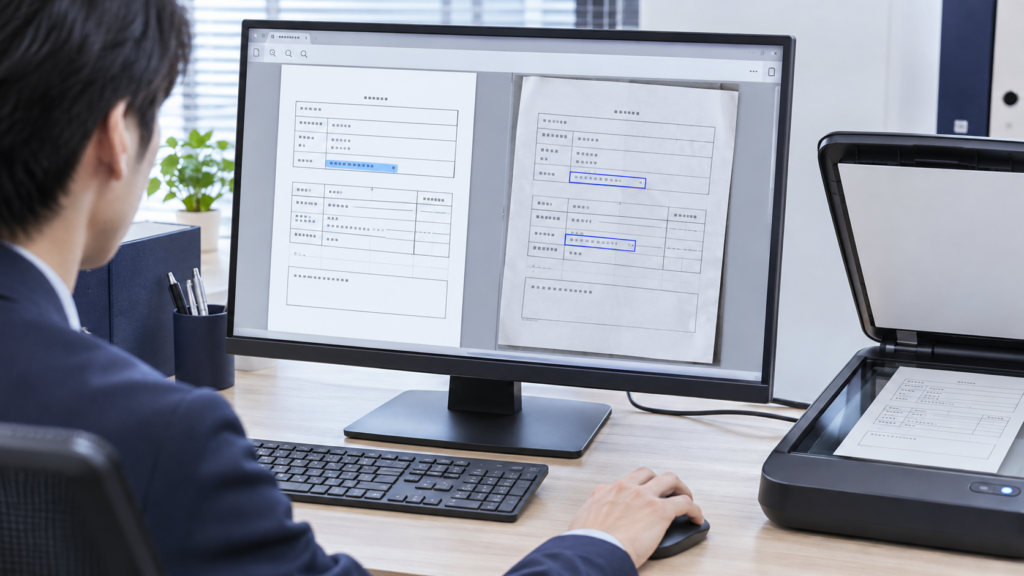
AIによる文字の読み取りでは、一般的にテキストPDFの方が有利です。テキストPDFは文字情報を直接抽出できるため、OCRによる誤認識を避けやすいという特徴があります。
一方、スキャンPDFは画像として保存されているため、OCRやAIの画像理解機能を使って文字を読み取る必要があります。そのため、画像の鮮明さや処理方法によって精度が変わります。
テキストPDFは文字情報を直接抽出できる
テキストPDFは、文字データを保持しているため、OCRを使わずに文章を取得できます。特に、契約書の条文や請求書の金額など、正確な文字情報が求められる場面で有利です。
ただし、複雑な表やレイアウトでは、文字の抽出順序が崩れることがあります。
スキャンPDFは画像の品質が精度に影響する
スキャンPDFでは、画像から文字を認識する工程が必要です。
解像度が低い場合や文字が不鮮明な場合は、数字や記号の誤認識、文字の欠落が発生する可能性があります。
一方、高品質な画像と適切なOCRを組み合わせることで、読み取り精度の改善が期待できます。
文字を正しく読み取れてもAIの回答が正確とは限らない
AIが文字を正しく抽出できても、文章の意味や表の構造を誤って理解することがあります。
そのため、PDFの読み取り精度を評価する際は、文字認識だけでなく、情報抽出や回答の正確性も確認することが重要です。
スキャンPDFとテキストPDFの比較
| 比較項目 |
テキストPDF |
スキャンPDF |
| 文字の抽出 |
文字データを直接取得できる |
OCRなどによる認識が必要 |
| 文字認識の精度 |
OCRによる誤認識を避けやすい |
画像品質によって変化 |
| 数値の読み取り |
比較的安定しやすい |
数字や記号を誤認識する可能性 |
| 表の読み取り |
構造が崩れる場合がある |
行や列を誤認識する場合がある |
| 画像品質の影響 |
文字抽出への影響は比較的小さい |
影響が大きい |
| 精度改善の方法 |
文字抽出方法の見直し |
OCR・画像補正 |
このように、テキストPDFは文字抽出で有利になりやすい一方、どちらの形式でもAIによる解釈ミスは発生します。業務で活用する際は、PDF形式だけでなく、読み取り結果の正確性も確認する必要があります。
スキャンPDF・テキストPDF・OCR処理済みPDFの仕組み
PDFは、文字情報の保存方法によって、スキャンPDF・テキストPDF・OCR処理済みPDFに分類できます。それぞれAIが情報を取得する仕組みが異なり、読み取り精度にも影響します。
スキャンPDFとは
スキャンPDFは、紙の書類を画像として保存したPDFです。
画像のみの場合は文字データが含まれていないため、AIが内容を読み取るにはOCRや画像理解機能が必要です。文字の鮮明さや解像度によって認識精度が変わります。
テキストPDFとは
テキストPDFは、WordやExcelなどから直接出力され、文字情報を保持しているPDFです。
AIは文字データを直接取得できるため、OCRによる誤認識を避けやすい特徴があります。ただし、複雑な表やレイアウトでは、文字の抽出順序が崩れる場合があります。
OCR処理済みPDFとは
OCR処理済みPDFは、スキャン画像から文字を認識し、検索やコピーができる文字情報を追加したPDFです。
画像のみのPDFより文字を活用しやすくなりますが、OCRによる誤認識が残る可能性があります。
3種類のPDFの比較
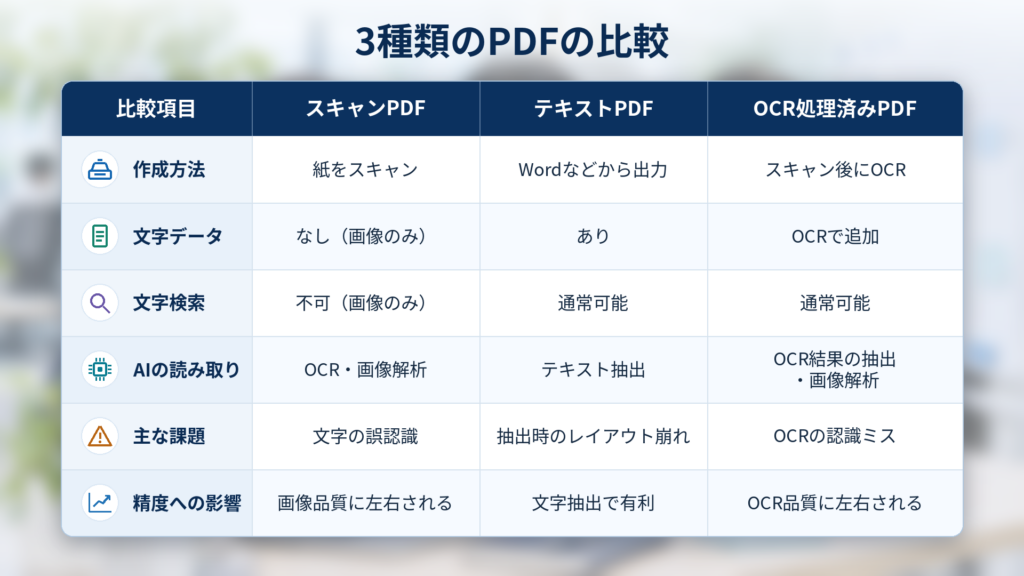
| 比較項目 |
スキャンPDF |
テキストPDF |
OCR処理済みPDF |
| 主な作成方法 |
紙をスキャン |
Wordなどから出力 |
スキャン後にOCR処理 |
| 文字データ |
画像のみの場合はなし |
あり |
OCRによって追加 |
| 文字検索 |
画像のみでは不可 |
通常可能 |
通常可能 |
| AIの読み取り方法 |
OCR・画像解析 |
テキスト抽出 |
OCR結果の抽出・画像解析 |
| 主な課題 |
文字の誤認識 |
レイアウトの崩れ |
OCRの認識ミス |
| 精度への影響 |
画像品質に左右される |
文字抽出では有利になりやすい |
OCRの品質に左右される |
AIがPDFを読み取るまでの処理フロー
AIは、PDFの内容や利用するサービスに応じて、主に次の手順で情報を処理します。
① 情報取得:PDF内の文字や画像を取得する。
② 文字認識:必要に応じてOCRを実行する。
③ 内容解析:文章や表の構造・意味を分析する。
④ 回答生成:質問や指示に応じて回答する。
実際には、文字情報と画像を組み合わせて解析するAIもあります。
そのため、読み取り精度を比較する際は、PDF形式だけでなく、OCRの有無やAIの処理方式も確認することが重要です。
AIのPDF読み取り精度を比較する5つの評価項目
AIのPDF読み取り精度は、文字を正しく認識できるかだけでは判断できません。数値や表の読み取り、情報の抽出漏れ、回答の正確性など、複数の項目で評価することが重要です。
1. 文字認識の正確性
PDF内の文字を原文どおりに読み取れているかを確認します。
特に、漢字や英数字、記号の誤認識、文字の欠落などが評価対象です。文字誤り率(CER)を使うことで、原文との差を数値化できます。
2. 数値・金額の正確性
請求金額や日付、数量などを正しく抽出できているかを確認します。
数字の桁数や小数点、項目との対応に誤りがないかが重要です。数値はわずかな違いでも業務上の問題につながる可能性があります。
3. 表・レイアウトの再現性
表の行と列、見出しと数値の対応を正しく認識できているかを評価します。
特に、複雑な表や複数段組みのPDFでは、読み取り順序が崩れ、情報を誤って関連付ける場合があります。
4. 必要情報の抽出漏れ
指定した情報を漏れなく取得できているかを確認します。
脚注や注釈、小さい文字、複数ページにまたがる情報などは見落とされる可能性があります。必要な項目のうち、正しく抽出できた割合を確認します。
5. AIの回答の正確性
抽出した情報をもとに、AIが正しく回答できているかを評価します。
文字認識が正確でも、文章の意味を誤解したり、原文にない内容を生成したりする場合があります。そのため、回答と原文の一致を確認することが重要です。
AIのPDF読み取り精度を評価する5つの指標
| 評価項目 |
主な確認内容 |
評価指標 |
| 文字認識 |
文字の誤認識・欠落 |
文字誤り率(CER) |
| 数値抽出 |
金額・日付・数量の一致 |
完全一致率 |
| 表の読み取り |
行・列・項目の対応 |
セル一致率 |
| 情報抽出 |
必要情報の取得漏れ |
再現率 |
| 回答の正確性 |
回答内容と原文の整合性 |
正答率・根拠一致率 |
これらの指標を組み合わせることで、PDF形式ごとの違いをより具体的に評価できます。
特に企業で利用する場合は、すべての項目を同じ重要度で評価するのではなく、業務に必要な情報を正確に取得できるかを重視することが大切です。
スキャンPDFでAIの読み取りミスが発生する6つの原因
スキャンPDFの読み取り精度は、画像の品質や文書のレイアウトによって変わります。特に、文字が不鮮明な場合や複雑な構造の文書では、誤認識や情報の欠落が発生しやすくなります。
ここでは、AIの読み取り精度を低下させる主な6つの原因を解説します。
1. スキャン解像度が低い
解像度が低いPDFでは、文字の輪郭が不鮮明になり、AIが正しく認識できないことがあります。特に、小さい文字や数字、記号で誤認識が発生しやすくなります。
Google CloudのDocument AIでは、OCRの精度を高めるために200dpi以上のスキャンを求めており、一般的には300dpi以上が良好な結果につながると説明しています。
2. PDFの文字が傾いている
書類を斜めにスキャンすると、文字の位置関係が変わり、読み取り精度に影響する場合があります。
特に、表や複数行の文章では、文字の認識だけでなく、読み取り順序が崩れる原因にもなります。
3. 影・汚れ・ノイズが含まれている
書類に影や汚れがあると、文字の一部が隠れたり、背景との区別が難しくなったりします。
その結果、文字の欠落や誤認識が発生する可能性があります。スキャン前に原稿の状態を確認することが重要です。
4. 小さい文字や複雑なフォントが使われている
文字が小さい場合や装飾の多いフォントでは、文字の形を正確に判別できないことがあります。
契約書の脚注や請求書の細かい項目などは、拡大しても文字が鮮明に見えるか確認する必要があります。
5. 表や複数段組みのレイアウトが複雑
複雑な表や複数段組みの文書では、AIが情報の配置を正しく理解できない場合があります。
例えば、請求書の品目と金額の対応を誤ったり、異なる列の文章をつなげて読み取ったりする可能性があります。
6. 画像圧縮によって文字が不鮮明になっている
PDFのファイルサイズを小さくするために画像を強く圧縮すると、文字の輪郭が崩れる場合があります。
一度失われた画像の細部は完全には復元できないため、元の画像品質を保った状態でPDFを作成することが大切です。
読み取りミスの原因と改善策の比較
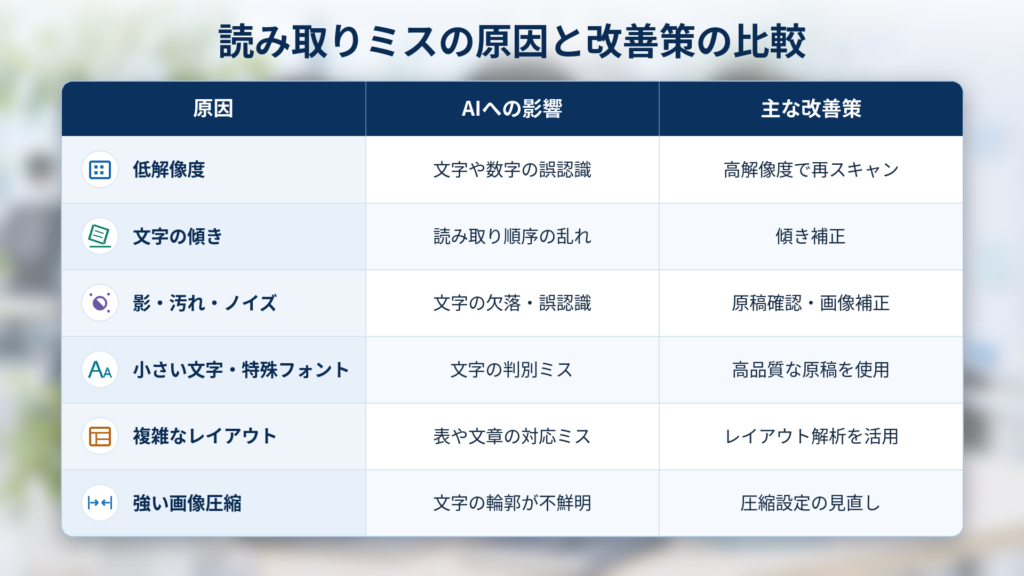
| 原因 |
AIへの影響 |
主な改善策 |
| 低解像度 |
文字や数字の誤認識 |
高解像度で再スキャン |
| 文字の傾き |
読み取り順序の乱れ |
傾き補正 |
| 影・汚れ・ノイズ |
文字の欠落・誤認識 |
原稿確認・画像補正 |
| 小さい文字・特殊フォント |
文字の判別ミス |
高品質な原稿を使用 |
| 複雑なレイアウト |
表や文章の対応ミス |
レイアウト解析を活用 |
| 強い画像圧縮 |
文字の輪郭が不鮮明 |
圧縮設定の見直し |
スキャンPDFの読み取りミスは、AIモデルだけでなく、入力する文書の品質によっても発生します。精度を改善するには、まずPDFの状態を確認し、原因に応じた対策を行うことが重要です。
スキャンPDFとテキストPDFのAI読み取り精度を比較検証する方法
スキャンPDFとテキストPDFの精度差を確認するには、同じ内容の文書を使い、条件をそろえて比較することが重要です。
ここでは、企業でも実施しやすい比較検証の手順を紹介します。
1. 同じ内容のPDFを3種類用意する
まず、同じ文書からテキストPDF・スキャンPDF・OCR処理済みPDFを作成します。内容を統一することで、PDF形式や前処理による違いを比較しやすくなります。
スキャンPDFは、元の文書を画像化して作成します。OCR処理済みPDFには、そのスキャンPDFを使い、文字認識の処理を追加します。
2. 検証する文書と確認項目を決める
検証には、実際の業務で使用する文書に近いものを選びます。文書の種類によって、確認すべき情報が異なるためです。
例えば、契約書では条文や契約期間、請求書では金額や日付、報告書では表や注釈の読み取りを確認します。
3. AIモデルと質問条件を統一する
3種類のPDFを同じAIモデルに入力し、同じ質問を使用します。モデルのバージョン、入力方法、検証日も記録しておきます。
例えば、請求書であれば「請求日、請求金額、取引先名を原文どおりに抽出してください」と指示します。
なお、AIサービスによっては、PDF内の文字と画像を組み合わせて解析します。そのため、比較時には実際の処理方式も確認する必要があります。
4. 正解データとAIの抽出結果を照合する
次に、元の文書を人が確認して正解データを作成し、AIの抽出結果と比較します。
文字の誤認識、数値の間違い、表の構造の崩れ、必要情報の欠落などを確認します。回答に原文と異なる内容が含まれていないかも重要な評価項目です。
5. 評価指標を使って精度を測定する
読み取り精度は、文字誤り率(CER)、完全一致率、再現率、回答正答率などを使って評価できます。
文字認識と回答の正確性を分けて測定することで、読み取り段階と内容理解のどちらに問題があるのかを分析しやすくなります。
PDF形式別の比較検証項目
| 検証項目 |
確認する内容 |
評価方法 |
| 文字認識 |
文字の誤認識・欠落 |
文字誤り率(CER) |
| 数値抽出 |
金額・日付・数量 |
完全一致率 |
| 表の読み取り |
行・列・項目の対応 |
セル一致率 |
| 情報抽出 |
必要情報の取得漏れ |
再現率 |
| 回答の正確性 |
回答と原文の一致 |
正答率・根拠一致率 |
6. 精度差が生じた原因を分析する
検証後は、PDF形式ごとの結果を比較し、どの項目で誤りが発生したかを整理します。
例えば、スキャンPDFだけで文字の誤認識が多い場合は、画像品質やOCR処理を確認します。文字抽出は正確でも回答が間違っている場合は、AIによる内容理解や情報の関連付けに問題がある可能性があります。
このように、同じ文書・同じ条件で比較することで、PDF形式による読み取り精度の違いと改善すべきポイントを把握できます。
PDFの読み取りミスが企業業務に与える影響
AIによるPDFの読み取りミスは、単なる文字の誤認識にとどまらず、業務上の判断やデータ処理にも影響します。
特に、契約書や請求書など、正確性が求められる文書では注意が必要です。
1. 契約書の条項や条件を誤って理解する
契約書では、契約期間や金額、解除条件などの読み取りミスが、誤った判断につながる可能性があります。
例えば、契約期間の日付を誤認識したり、例外条件を読み飛ばしたりすると、契約内容を正しく把握できません。重要な条項は原文との照合が必要です。
2. 請求書の金額や数量を誤認識する
請求書では、請求金額や数量、支払期限などの誤認識が、経理処理の間違いにつながる可能性があります。
特に、数字の桁数や小数点、品目と金額の対応を確認することが重要です。
3. 報告書の表や数値を誤って解釈する
報告書では、表の行や列を誤って読み取ることで、数値と項目の対応が崩れる場合があります。
例えば、異なる期間の売上を取り違えると、AIによる分析や要約にも誤りが生じる可能性があります。
4. 確認・修正工数が増加する
AIの読み取り結果に誤りが多い場合、人による確認や修正が必要となり、業務負担が増加します。
また、誤ったデータを後続業務に利用すると、処理のやり直しが発生する可能性もあります。
PDFの読み取りミスと業務リスクの比較
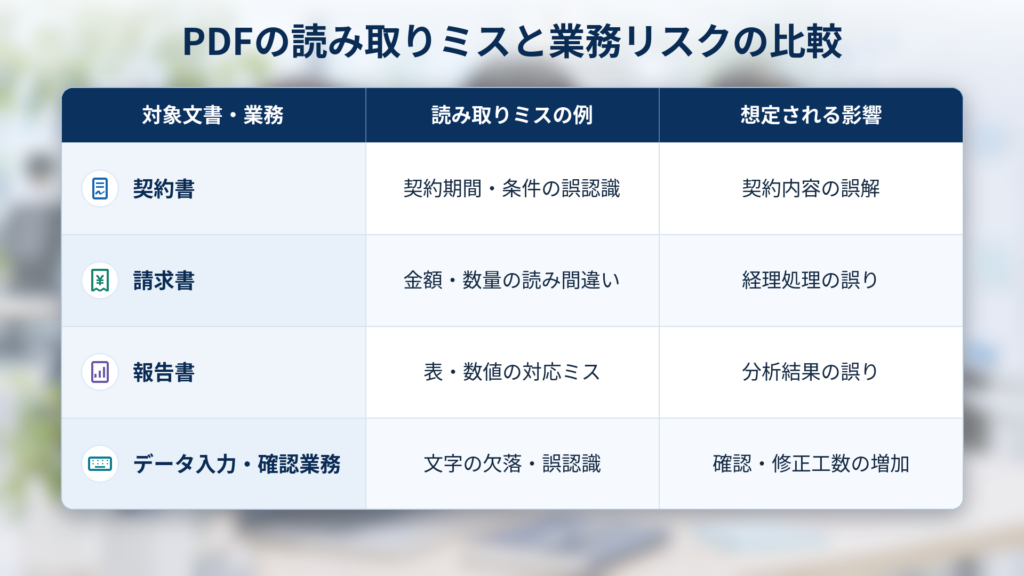
| 対象文書・業務 |
読み取りミスの例 |
想定される影響 |
| 契約書 |
契約期間・条件の誤認識 |
契約内容の誤解 |
| 請求書 |
金額・数量の読み間違い |
経理処理の誤り |
| 報告書 |
表・数値の対応ミス |
分析結果の誤り |
| データ入力・確認業務 |
文字の欠落・誤認識 |
確認・修正工数の増加 |
このように、PDFの読み取りミスは、文書の種類によって異なる業務リスクを生みます。
企業でAIを活用する際は、読み取り精度だけでなく、誤認識が業務に与える影響も考慮し、重要な情報を優先して確認することが大切です。
生成AIを導入したものの、業務で十分に活用できていないと感じていませんか?
ChatGPTをはじめとする生成AIは、導入するだけでは十分な効果を発揮できない場合があります。
当社では、業務課題の整理から活用方法の設計、プロンプト作成、社員研修、運用ルールの整備まで一貫してサポートします。
自社に最適な生成AI活用について、お気軽にご相談ください。
生成AI活用について相談する
AIのPDF読み取り精度を高める7つの改善策
AIのPDF読み取り精度を高めるには、AIモデルの性能だけでなく、PDFの作成方法や事前処理を見直すことが重要です。
ここでは、企業で実践しやすい7つの改善策を紹介します。
1. 元データからテキストPDFを生成する
WordやExcelなどの元データがある場合は、直接PDFに出力する方法が有効です。文字情報を保持できるため、OCRによる誤認識を避けやすくなります。
2. スキャン時の解像度を適切に設定する
紙の書類をスキャンする場合は、文字が鮮明に保存されるよう解像度を設定します。特に、小さい文字や数字が含まれる文書では、画像品質の確認が重要です。
3. OCR処理によって文字情報を追加する
画像のみのPDFにはOCRを適用し、文字を検索・抽出できる状態にします。ただし、OCRの認識結果に誤りが残る場合があるため、重要な情報は確認が必要です。
4. 画像の傾き・影・ノイズを補正する
スキャン画像の傾きや影、汚れを補正することで、文字を認識しやすい状態に整えます。補正後は、文字の一部が消えていないかも確認します。
5. 表や帳票に対応した文書解析ツールを活用する
請求書や複雑な表を含むPDFでは、文字認識だけでなく、行・列や項目の関係を解析できるツールが有効です。文書の構造に適した処理方式を選びます。
6. AIへの指示と出力形式を明確にする
AIには、抽出する項目や回答形式を具体的に指定します。例えば、金額・日付・取引先名を表形式で出力し、不明な項目は推測せず「不明」と記載するよう指示します。
ただし、指示の改善だけで、元画像の不鮮明さやOCRの誤認識を解消できるとは限りません。
7. 重要情報は原文と照合する
契約金額や支払期限など、誤りが業務に影響する情報は、AIの抽出結果と原文を照合します。確認対象を事前に決めることで、必要なチェックを行いやすくなります。
7つの改善策と確認ポイントの比較
| 改善策 |
対象となる問題 |
確認ポイント |
| テキストPDFの生成 |
OCRによる文字の誤認識 |
文字を正しく抽出できるか |
| 解像度の改善 |
文字の不鮮明さ |
小さい文字も判別できるか |
| OCR処理 |
文字データの欠如 |
認識結果が原文と一致するか |
| 画像補正 |
傾き・影・ノイズ |
補正による文字の欠落がないか |
| 文書解析ツール |
表や帳票の構造の崩れ |
項目と数値が対応しているか |
| AIへの指示改善 |
抽出条件の曖昧さ |
指定項目を正しく出力できるか |
| 原文との照合 |
抽出結果の誤り |
重要情報に間違いがないか |
PDFの読み取り精度を改善するには、文字認識・文書解析・回答生成のどの段階で問題が発生しているかを確認することが重要です。
原因に応じて適切な対策を組み合わせることで、読み取りミスの削減と確認作業の効率化が期待できます。
企業で使うならどちらのPDF形式を選ぶべきか?
企業がAIでPDFを処理する際は、文書の種類や業務目的に応じて適切な形式を選ぶことが重要です。
文字の正確な抽出を重視する業務と、図表やレイアウトの理解が必要な業務では、適した処理方法が異なります。
1. 契約書や規程の確認ではテキストPDFを優先する
契約書や社内規程では、条文や日付、金額などを正確に読み取る必要があります。
元データがある場合はテキストPDFを優先し、条項番号や例外条件などの重要情報は原文と照合します。
2. 紙の請求書はOCRと数値確認を組み合わせる
紙の請求書を処理する場合は、スキャンPDFにOCRを適用し、金額や日付などを抽出する方法が考えられます。
特に、請求金額や数量、支払期限については、原文との一致を確認することが重要です。
3. 図表の多い報告書は画像理解機能も検討する
報告書や会議資料には、グラフや図解、複雑な表が含まれることがあります。
文字抽出だけでは図表の意味を十分に取得できない場合があるため、画像理解機能やレイアウト解析に対応したAIの活用を検討します。
4. 大量の社内文書は検索可能な形式に整備する
社内マニュアルや過去の資料をAIで検索する場合は、文字情報を取得できる状態に整備することが重要です。
スキャンPDFには必要に応じてOCRを適用し、文書名やページ番号などの情報を保持することで、検索結果を原文と照合しやすくなります。
業務別の推奨PDF形式と確認ポイント
| 対象業務 |
推奨形式・処理方法 |
重要な確認項目 |
| 契約書確認 |
テキストPDFを優先 |
条文・契約期間・例外条件 |
| 請求書処理 |
OCR・帳票解析 |
金額・数量・支払期限 |
| 報告書分析 |
テキスト抽出・画像解析 |
表・グラフ・注釈 |
| 社内文書検索 |
OCR・検索用データ整備 |
検索漏れ・参照元 |
| 規程・マニュアル |
テキストPDFを優先 |
見出し・手順・適用条件 |
このように、最適なPDF形式は業務の目的によって異なります。文字の正確性を重視する場合はテキストPDFを優先し、紙文書や複雑な図表を扱う場合はOCRや画像解析を組み合わせる方法が有効です。
企業では、文書の形式だけで判断せず、必要な情報を正確に取得できるかを事前に検証することが重要です。
生成AIを導入したものの、業務で十分に活用できていないと感じていませんか?
ChatGPTをはじめとする生成AIは、導入するだけでは十分な効果を発揮できない場合があります。
当社では、業務課題の整理から活用方法の設計、プロンプト作成、社員研修、運用ルールの整備まで一貫してサポートします。
自社に最適な生成AI活用について、お気軽にご相談ください。
生成AI活用について相談する
企業がPDF読み取りAIを導入する際の注意点
企業がPDF読み取りAIを導入する際は、読み取り精度だけでなく、確認体制や情報管理、運用コストも考慮する必要があります。
特に、重要な文書を扱う場合は、AIの処理結果を安全に活用できる仕組みを整えることが重要です。
1. 業務ごとに必要な精度を設定する
PDFの読み取りに求められる精度は、業務によって異なります。例えば、資料の要約と請求金額の抽出では、誤りが生じた場合の影響が異なります。
導入前に重要な項目を整理し、許容できる誤りの範囲や確認方法を決めることが必要です。
2. 重要情報の確認体制を整える
AIの抽出結果には、文字の誤認識や内容の解釈ミスが含まれる可能性があります。
契約条件や金額など、業務上重要な情報については、人による確認や原文との照合を行う体制が必要です。
3. 個人情報・機密情報を適切に管理する
契約書や社内資料には、個人情報や取引先の機密情報が含まれる場合があります。
AIサービスにPDFを入力する前に、データの保存・利用条件、アクセス権限、社内の情報管理ルールを確認することが重要です。
4. 精度と確認工数を継続的に評価する
AI導入後も、読み取りミスの件数や修正作業にかかる時間を継続的に確認します。
精度だけでなく、OCR処理や人による確認を含めた作業時間を評価することで、業務改善につながっているかを判断できます。
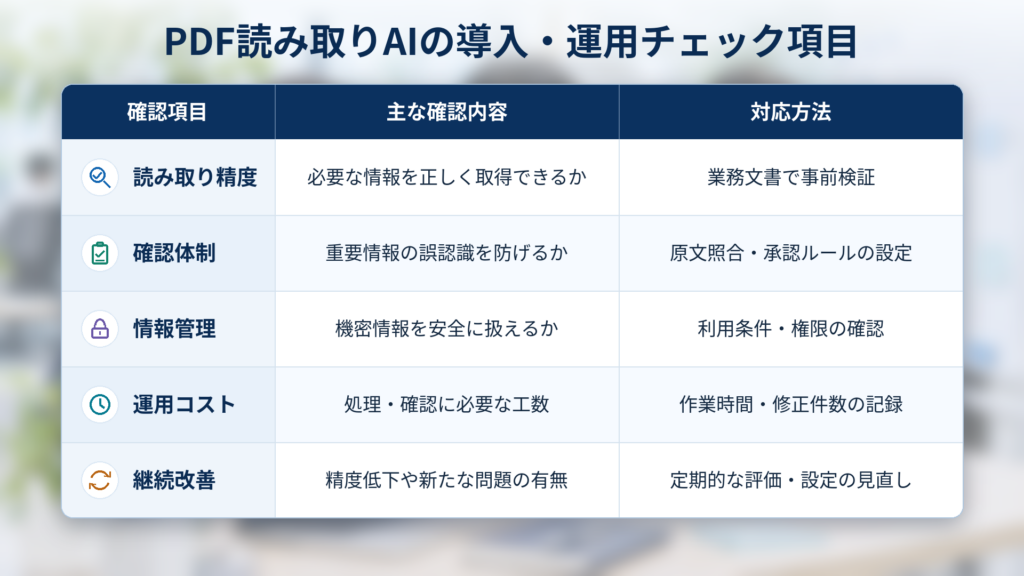
PDF読み取りAIの導入・運用チェック項目
| 確認項目 |
主な確認内容 |
対応方法 |
| 読み取り精度 |
必要な情報を正しく取得できるか |
業務文書で事前検証 |
| 確認体制 |
重要情報の誤認識を防げるか |
原文照合・承認ルールの設定 |
| 情報管理 |
機密情報を安全に扱えるか |
利用条件・権限の確認 |
| 運用コスト |
処理・確認に必要な工数 |
作業時間・修正件数の記録 |
| 継続改善 |
精度低下や新たな問題の有無 |
定期的な評価・設定の見直し |
PDF読み取りAIを安定して運用するには、技術面の改善だけでなく、業務に応じた確認ルールと情報管理体制が必要です。
導入前の精度検証と導入後の継続的な評価を組み合わせることで、読み取りミスによるリスクを抑えながらAIを活用できます。
スキャンPDFとテキストPDFのAI読み取りに関するよくある質問30選
スキャンPDFとテキストPDFの違いや、AIの読み取り精度、OCRの活用方法について、よくある質問をまとめました。
FAQの主な内容
| 分類 |
主な内容 |
該当する質問 |
| PDF形式 |
種類・見分け方・変換 |
Q1〜Q5 |
| AIの読み取り精度 |
認識精度・回答の正確性 |
Q6〜Q10 |
| OCR |
文字認識・解像度・誤認識 |
Q11〜Q15 |
| 表・レイアウト |
表・グラフ・注釈の読み取り |
Q16〜Q20 |
| 精度検証・改善 |
評価指標・改善方法 |
Q21〜Q25 |
| 企業での利用 |
契約書・請求書・導入時の注意点 |
Q26〜Q30 |
PDF形式に関する質問
Q1. スキャンPDFとテキストPDFはどう見分けますか?
PDF内の文字を選択・コピーできるか確認する方法があります。ただし、OCR処理済みPDFも文字を選択できるため、正確に判別するにはPDF内部の文字情報を確認する必要があります。
Q2. 文字をコピーできるPDFは必ずテキストPDFですか?
必ずしもそうではありません。スキャンPDFでもOCR処理によって文字情報が追加されていれば、文字の選択やコピーが可能です。
Q3. OCR処理済みPDFとテキストPDFは何が違いますか?
テキストPDFは元データの文字情報を保持しているのに対し、OCR処理済みPDFは画像から認識した文字情報を追加しています。そのため、後者にはOCRによる誤認識が残る場合があります。
Q4. スキャンPDFをテキストPDFに変換できますか?
OCRを利用すれば、スキャンPDFに文字情報を追加できます。ただし、元のWordなどから作成したPDFと完全に同じ文字情報や構造になるとは限りません。
Q5. Wordから作成したPDFでも文字化けすることはありますか?
あります。フォントや文字コードの扱いによって、表示が正常でも文字を抽出すると文字化けする場合があります。PDFの作成後にコピー結果を確認するとよいでしょう。
AIの読み取り精度に関する質問
Q6. ChatGPTはスキャンPDFを読み取れますか?
画像解析に対応した機能を利用できる環境では、スキャンPDFの文字や図表を読み取れる場合があります。ただし、対応範囲は利用プランやファイルの入力方法によって異なります。
Q7. スキャンPDFはテキストPDFより必ず精度が低いですか?
必ずしもそうではありません。一般的に文字抽出ではテキストPDFが有利ですが、スキャン画像の品質やAIの処理方式によって結果は異なります。
Q8. AIが文字を正しく認識しても回答を間違えることはありますか?
あります。文字を正しく取得していても、文脈を誤解したり、原文にない情報を生成したりする可能性があります。重要な回答は根拠を確認する必要があります。
Q9. 日本語の縦書きPDFは読み取れますか?
縦書きに対応したOCRやAIであれば読み取れる場合があります。ただし、縦書きへの対応状況はツールによって異なるため、事前の確認が必要です。
Q10. 手書き文字を含むPDFは読み取れますか?
手書き文字に対応したOCRやAIであれば読み取れる場合があります。ただし、文字の崩れや重なりによって認識精度が低下する可能性があります。
OCRに関する質問
Q11. OCRを使うと読み取り精度は向上しますか?
OCRによって画像から文字情報を取得できるため、検索や文字抽出がしやすくなります。ただし、OCR自体が誤認識する場合もあり、必ず精度が向上するとは限りません。
Q12. OCRの認識ミスはどのように確認しますか?
OCRで抽出した文字と元のPDF画像を比較します。特に、金額や日付、固有名詞などの重要な情報を優先して確認する方法が有効です。
Q13. OCR処理済みPDFでも数字を間違えることはありますか?
あります。数字とアルファベットの形が似ている場合や、小数点が不鮮明な場合などに誤認識する可能性があります。金額などは原文との照合が必要です。
Q14. AIの画像理解とOCRは何が違いますか?
OCRは主に画像内の文字を認識する技術です。一方、AIの画像理解機能は、文字だけでなく図や配置なども含めて内容を解析できます。
Q15. OCRに適したスキャン解像度はどのくらいですか?
Google CloudのDocument AIでは200dpi以上が求められ、一般的に300dpi以上で良好な結果が得られるとされています。実際には使用するOCRの仕様や原稿の状態に合わせて設定します。
表・レイアウトに関する質問
Q16. PDF内の表が正しく読み取れない原因は何ですか?
複雑なセル結合や罫線、複数行の見出しなどが原因になる場合があります。表の構造を解析できるツールの利用が有効です。
Q17. 複数段組みのPDFは読み取り順序が変わりますか?
変わる場合があります。異なる列の文章がつながったり、読み取り順序が入れ替わったりするため、段落の関係を確認する必要があります。
Q18. PDF内のグラフをAIが理解することはできますか?
画像理解に対応したAIであれば、グラフの傾向や項目を解析できる場合があります。ただし、細かい数値は誤認識する可能性があるため、元データとの照合が重要です。
Q19. 脚注や注釈が読み飛ばされることはありますか?
あります。小さい文字や本文から離れた位置にある注釈は、認識や抽出の対象から漏れる場合があります。重要な条件が含まれていないか確認します。
Q20. 複数ページにまたがる表を正しく読み取れますか?
読み取れる場合もありますが、ページをまたぐことで見出しと数値の関係が崩れる可能性があります。前後のページを含めて確認することが重要です。
精度検証・改善に関する質問
Q21. AIのPDF読み取り精度はどのように測定しますか?
正解データを用意し、AIの抽出結果と比較します。文字誤り率や完全一致率、回答正答率などを使い、評価項目ごとに測定します。
Q22. 文字誤り率(CER)とは何ですか?
CERは、正解の文字列に対して、置換・欠落・余分な文字がどの程度発生したかを表す指標です。一般的に数値が低いほど文字認識の誤りが少ないことを示します。
Q23. プロンプトを改善すればOCRの誤認識も減りますか?
プロンプトの改善は、抽出項目や回答形式の明確化に役立ちます。ただし、OCRで誤って認識された文字を必ず修正できるわけではありません。
Q24. PDFのファイルサイズは読み取り精度に影響しますか?
ファイルサイズだけで精度は決まりません。ただし、画像を強く圧縮して文字が不鮮明になると、認識精度に影響する可能性があります。
Q25. スキャンPDFの傾きは自動補正できますか?
傾き補正に対応した画像処理ツールやOCRサービスを利用すれば、自動補正できる場合があります。補正後に文字や表の配置が崩れていないか確認します。
企業での利用に関する質問
Q26. 契約書をAIで確認する場合はどのPDFが適していますか?
文字情報を直接取得できるテキストPDFが適しています。ただし、契約条件や例外事項の解釈には誤りが生じる可能性があるため、原文との照合が必要です。
Q27. 請求書の金額をAIで抽出する場合の注意点は何ですか?
請求金額だけでなく、税額・数量・単価・支払期限との対応を確認します。特に、数字の桁数や小数点の誤認識に注意が必要です。
Q28. 大量のスキャンPDFをAIで一括処理できますか?
一括処理に対応したOCRや文書解析サービスを利用すれば可能です。ただし、ファイルサイズやページ数などの処理上限を事前に確認する必要があります。
Q29. AIの抽出結果はすべて人が確認する必要がありますか?
確認の範囲は業務リスクに応じて判断します。契約条件や金額など、誤りによる影響が大きい情報は、人による確認を組み込むことが重要です。
Q30. PDF読み取りAIを導入する前に確認すべきことは何ですか?
対象文書の種類、必要な読み取り精度、確認体制、情報管理ルールを整理します。そのうえで、実際の業務文書を使って精度と運用負荷を検証することが重要です。
まとめ|PDFの読み取り精度は形式・画像品質・AIの処理方法によって変わる
スキャンPDFとテキストPDFでは、AIが文字情報を取得する仕組みが異なります。テキストPDFは文字を直接抽出できるため、一般的に文字認識の面で有利です。
一方、スキャンPDFは画像品質やOCRの性能によって精度が変わります。また、どちらの形式でも、表の構造や文章の意味をAIが誤って解釈する可能性があります。
PDF形式別の重要ポイント
| PDF形式 |
主な特徴 |
重要な対策 |
| テキストPDF |
文字情報を直接抽出できる |
抽出順序・内容の確認 |
| スキャンPDF |
画像品質が認識精度に影響 |
解像度・画像品質の改善 |
| OCR処理済みPDF |
画像から認識した文字情報を保持 |
OCR結果と原文の照合 |
企業がPDF読み取りAIを活用する際は、業務に適した形式を選び、実際の文書を使って精度を検証することが重要です。
PDFの事前処理と重要情報の確認を組み合わせることで、読み取りミスを抑え、AIをより安全かつ効果的に活用できます。
SUPERVISED BY
平出 大輔
株式会社Start Challenge Consulting
代表取締役CEO/AI・DXコンサルタント
約10年間、外資系コンサルティングファームにて企業のDX推進・業務改革・AI活用支援など数多くのプロジェクトを担当。これまで培った知見をもとに株式会社Start Challenge Consultingを創業し、生成AI、データ活用、DX推進を軸とした経営・業務改革支援を行っています。
「仕事=生きがい・楽しさ」という価値観を大切にし、クライアントと同じ目線で未来を創る真のパートナーとして、日本を代表するコンサルティングファームを目指しています。